
 English
1828个位点、AI识别甲基化肽段:蛋白甲基化研究的“高置信地图”来了
一句话结论
2026年7月,Wang、Jones、Vizcaíno等人在bioRxiv发表预印本研究:他们用统一、开源的质谱流程重分析8个人类甲基化富集数据集,绘制出仅含1828个位点的人类蛋白甲基化“高置信图谱”;再以此为基础,把原先训练在磷酸化数据上的深度学习模型AHLF通过迁移学习改造成“AHLF-Methylation”,识别甲基化肽段谱图的平均ROC-AUC达到0.824,为这一难以捉摸的翻译后修饰提供了AI辅助的检测新工具。
为什么蛋白甲基化那么难“看清”?
赖氨酸(K)和精氨酸(R)甲基化调控染色质、转录和信号通路,但用质谱 confident 地检测并定位这个修饰一直很难。核心痛点有两个:
- 质量偏移小:甲基化只带来约14 Da的质量增加,和肽段序列差异、同分异构、可变修饰等造成的质量偏移很容易混淆。 - 假定位率高:常规搜索+FDR控制不能保证位点定位正确;很多既往研究可能把“搜到了甲基化肽”直接当成“确定位点”,导致结果里混进大量假阳性。
因此,这篇工作的第一步不是堆更多数据,而是先做严格的质量控制。
数据集与统一流程:TPP + 诱饵氨基酸FLR
研究团队整合了8个公开的人类甲基化富集蛋白质组数据集,使用:
- Trans-Proteomic Pipeline(TPP) 进行数据库搜索; - 诱饵氨基酸(decoy amino acid)FLR策略 独立估计假定位率(FLR)。
结果很严格:8个数据集中,2个数据集(PXD005497、PXD023727)在1% FLR过滤后位点数为0,被排除;剩下6个数据集进入后续分析。
人类甲基化图谱:Gold / Silver / Bronze 三级置信
最终得到的人类甲基化图谱包括:
- 1828个高置信甲基化位点 - 1021个蛋白 - 其中:甲基-精氨酸 1771个,甲基-赖氨酸 57个
按置信度分为三级:
- Gold(金级):在至少2个数据集中以<1% FLR被鉴定 → 156个位点 - Silver(银级):在1个数据集中以<1% FLR被鉴定 → 362个位点 - Bronze(铜级):以<5% FLR被鉴定 → 1310个位点
这个数字明显少于以往研究,作者认为恰恰说明:过去很多报道的“甲基化位点”可能因为缺乏严格FLR控制而被高估。诱饵氨基酸方法把14 Da这种容易混淆的质量偏移产生的假阳性有效筛除。
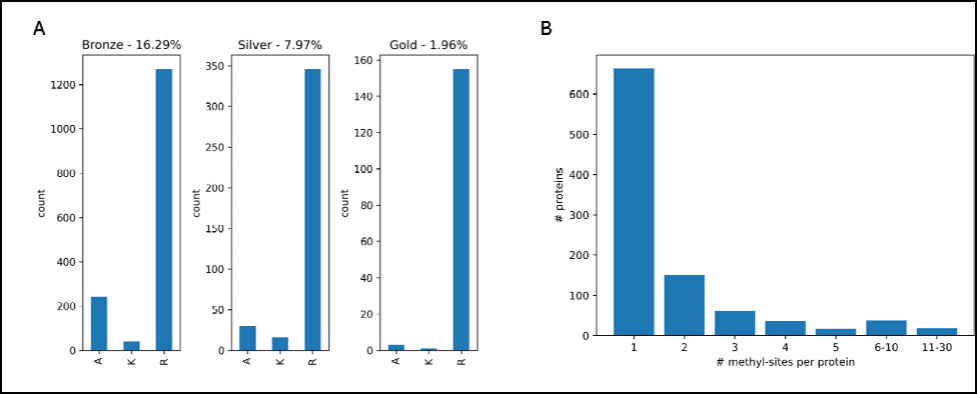
图1说明:A)Gold/Silver/Bronze三级中,按精氨酸(R)、赖氨酸(K)、诱饵丙氨酸(A)分类的位点分布;精氨酸甲基化占绝对主导,金级中155个是R、仅1个是K。B)每个蛋白携带的甲基化位点数量分布,大多数蛋白只有1个位点,少数蛋白高度甲基化。
AI登场:把磷酸化模型迁移到甲基化
有了高质量谱图,下一步是训练AI识别甲基化肽段。难点在于:甲基化阳性谱图太少,从头训练深度学习模型不现实。
研究团队采取的路线是迁移学习:
- 基础模型:AHLF(Ad Hoc Learning of Peptide Fragmentation),原先在海量磷酸化肽段谱图上预训练; - 训练数据:人类+小鼠共 58,486张 高置信甲基化肽段谱图; - 输出模型:AHLF-Methylation。
实验设计上,他们把数据按肽段序列分组划分训练/验证/测试集,避免序列泄漏;并微调了AHLF的4个预训练变体(α、β、γ、δ)。
主要性能(人类数据测试集)
- 平均 ROC-AUC:0.824 - 平均 F1-score:0.689 - 4个模型中 β变体表现最好,ROC-AUC达到 0.852
加入3个小鼠数据集(额外1324张真阳性谱图)后的混合模型(AHLF-Methyl-HM)平均ROC-AUC为 0.829,说明跨物种保守的碎裂模式可以帮助模型,但小鼠数据量小,提升有限。
训练数据多少才够?降到10%仍能用
作者还测试了训练数据量对性能的影响:从100%逐步降到10%。
- 100%:平均AUC 0.823 - 90%:0.815 - 70%:0.810 - 50%:0.779 - 20%:最低,0.733 - 10%:反而回升到0.777(作者解释为子集肽段组成带来的波动)
总体趋势:数据越少性能越差,但不是严格线性;子集组成和数据平衡同样重要。
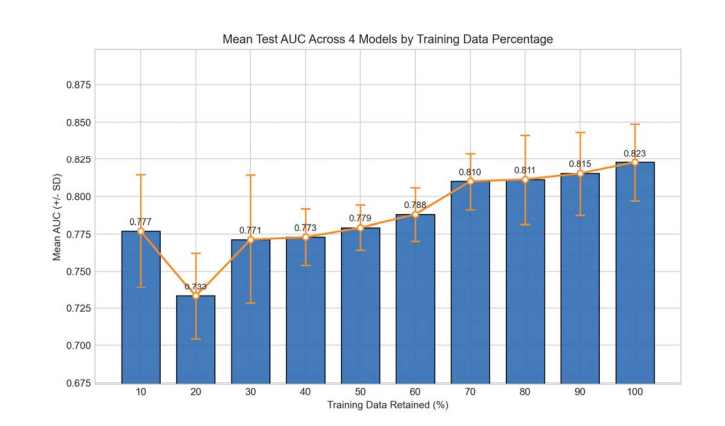
图2说明:4个AHLF-Methylation变体在不同训练数据比例下的平均测试AUC;误差棒为标准差。100%训练集性能最高,20%最低。
模型在“看”什么?SHAP解释
用SHAP值做模型解释后发现:AHLF-Methylation更多依赖与理论肽段碎片离子匹配的峰,而不是简单追逐最高强度峰。这说明迁移学习后的模型确实学到了有化学意义的谱图证据,而不是数据伪影。
不过作者也谨慎指出:这并不等于模型已经掌握了甲基化位点特异性诊断离子,只是证明甲基化肽段谱图适合作为AI-ready训练资源。
局限与启示
- 精氨酸偏向:金级位点几乎都是精氨酸甲基化,因为公共数据集多来自PRMT抑制相关实验;赖氨酸甲基化数据仍稀缺。 - 类别不平衡:阴性(非甲基化)谱图远多于阳性,模型天然偏向多数类;未来需要数据增强、合成谱图或代价敏感学习。 - 14 Da的“模糊地带”:甲基化质量偏移小,搜索空间、同分异构、可变修饰都会带来竞争解释,严格FLR是必需的。
数据已开放
这个高置信人类甲基化图谱已提交至 PTMeXchange 和 PRIDE, curated位点证据也已整合到 UniProt 和 PeptideAtlas。
对我们的启发
对做蛋白质组修饰分析的团队来说,这篇工作至少有三点可借鉴:
先做严格FDR/FLR,再谈位点数
:甲基化这种小质量偏移修饰,没有独立FLR控制,位点清单很可能虚高。 迁移学习是修饰AI化的可行路径
:当阳性谱图不足时,从磷酸化等大数据预训练模型迁移,比从头训练更现实。 公开数据重分析能创造新资源
:8个公开数据集+统一流程,就能产出一个被UniProt收录的高质量图谱。