
 English
quantmsdiann:公共DIA数据重分析新工作流,2.2小时跑完2300样本,蛋白组鉴定最高提升59%
一句话结论:quantmsdiann 是一个基于 Nextflow / nf-core 的 DIA-NN 自动化工作流。它用 SDRF 文件驱动每个样本的检索参数,把原始 DIA 数据并行分发到 HPC/云节点上,能在 300 个节点上 2.2 小时跑完 2,300 个单细胞样本;用最新版 DIA-NN 重跑已发表的公共数据,蛋白组鉴定数可比原始发表结果提升 12%–59%。
DIA 质谱数据正在公共存档里爆发式增长。但大多数数据只被分析过一次:作者当年用什么软件、什么版本、什么参数,外人很难完全复刻,更谈不上批量重分析。结果就是,已经花了钱采到的原始数据,里面还有大量可挖掘信息被闲置。
1. quantmsdiann 是什么?
quantmsdiann 是一个开源的 SDRF 驱动型 Nextflow 工作流,专门围绕 DIA-NN 构建。核心设计有以下几点:
- SDRF 驱动:每个样本的仪器类型、梯度、标记方式等元数据写入 SDRF,工作流自动翻译成 DIA-NN 参数。 - 容器锁定:每个支持的 DIA-NN 版本(1.8.1 到 2.5.1,包括 enterprise)都有独立的 Docker/Singularity 容器配置,换版本时不需要重装。 - 并行架构:每个原始文件可以单独跑前处理、校准、检索,只有谱图库生成、经验库组装、最终定量等步骤需要全队列汇总,天然适配 HPC/云。
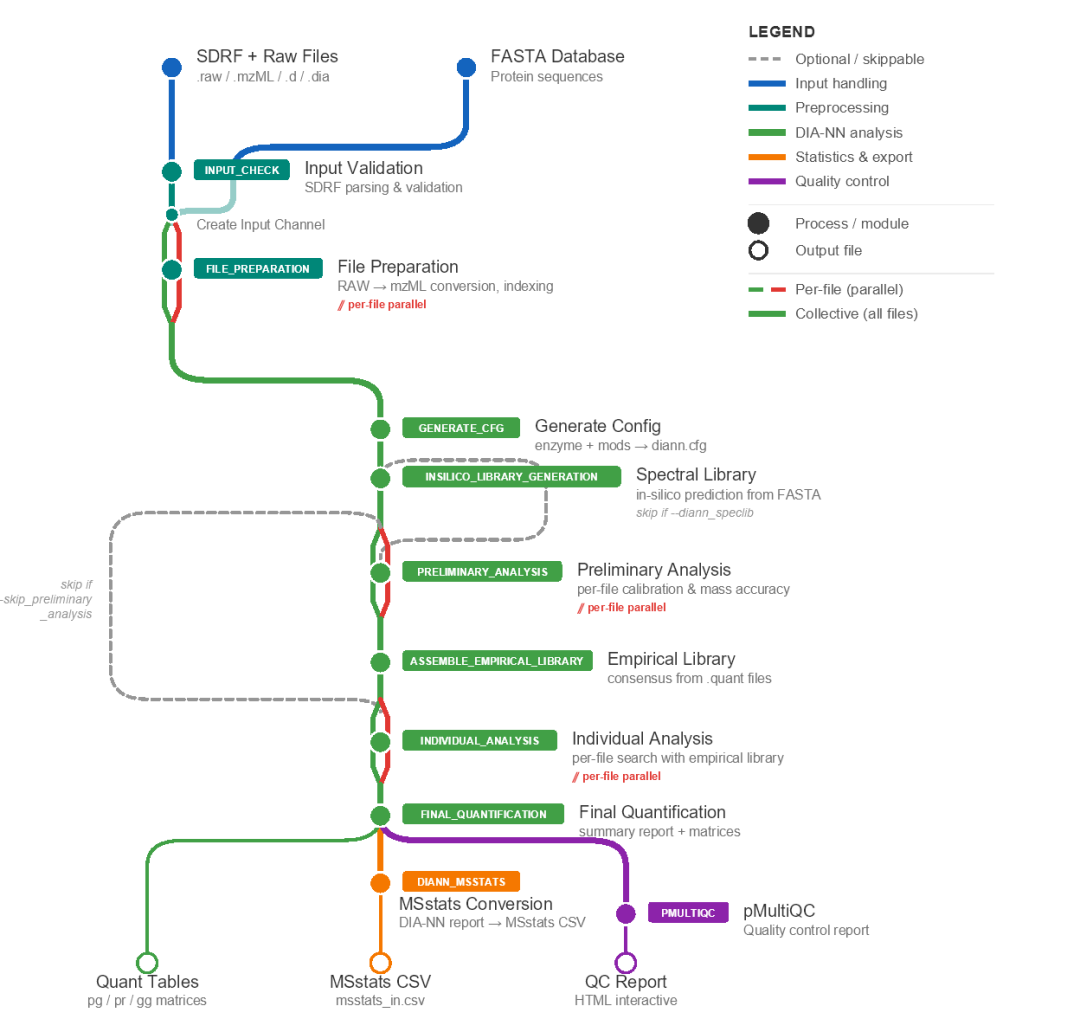
▲ 图1. quantmsdiann 工作流概览:红色为每文件并行步骤,绿色为全队列汇总步骤,最终输出 DIA-NN 报告、MSstats CSV、QPX Parquet 和 pMultiQC 报告。
2. 并行化不影响定量准确性
作者先用 ProteoBench 做了对照:把同一套 HYE 三物种混合样本数据,分别用单机 DIA-NN 和分布式 quantmsdiann 跑了一遍。
- 运行时间:2,300 个单细胞样本在 300 个 HPC 节点上只要 2.2 小时;5,798 个 ProCan 细胞系运行也只需 6.2 小时。 - 定量准确性:log2 比值与预期值完全落在同一分布里,说明分布式编排只是换了个执行方式,并没有改结果。 - 不同 DIA-NN 版本:在四个 DIA 平台(Astral、single-cell、diaPASEF、ZenoTOF)上,2.5.1 版本的鉴定深度普遍高于 1.8.1。
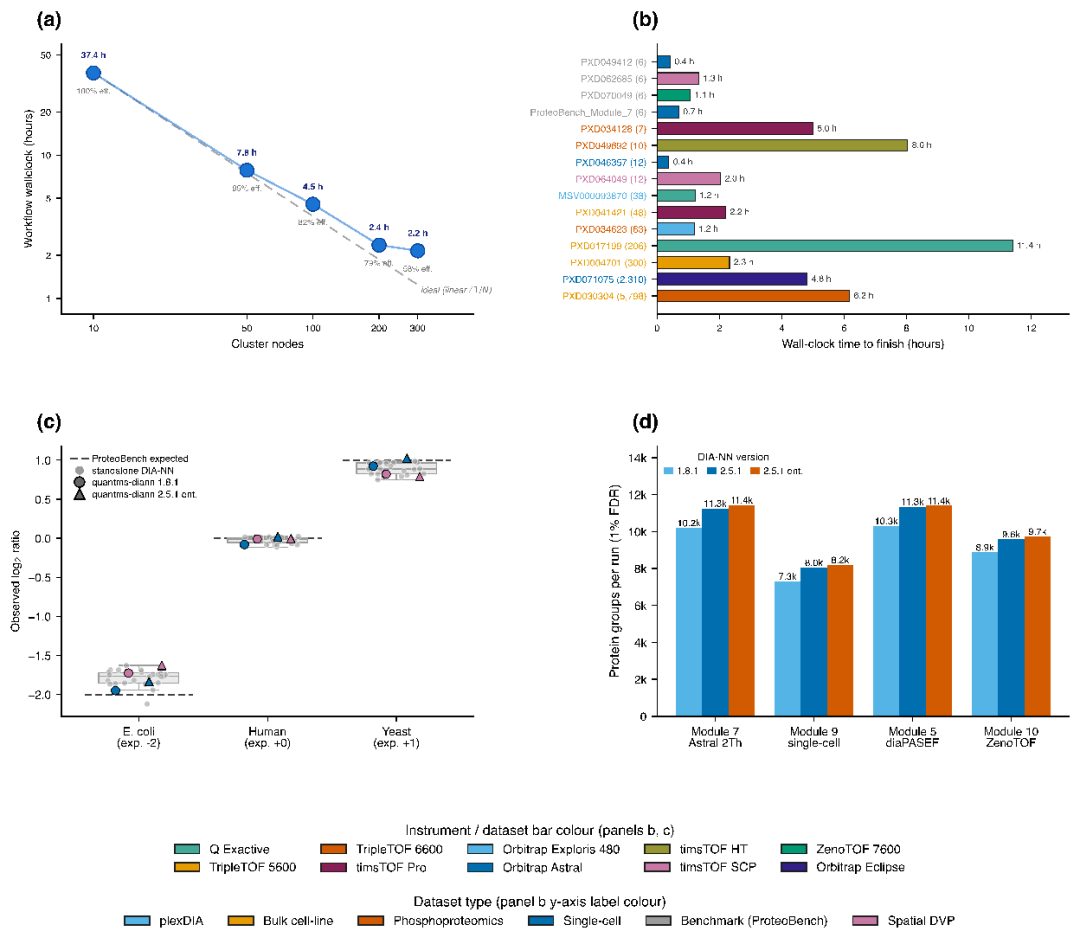
▲ 图2. 并行性能与 ProteoBench 定量准确性验证。a 为节点数与 wall-clock 时间;b 为多个公开队列的运行时间;c 为 HYE 混合物定量准确性;d 为不同 DIA-NN 版本/平台下的蛋白组鉴定深度。
3. 升级 DIA-NN,单细胞数据也能多鉴定蛋白
在单细胞 DIA 数据上,升级引擎带来的收益很明显。以 HeLa Astral 和 A549/H460 两个单细胞队列为例:
- 总 precursor 提升 16%–17% - 总蛋白组提升 7%–17% - 每个单细胞的中位蛋白组数提升 17%–23% - 数据完整性曲线明显上移,说明跨 run 匹配传播更强 - CV 分布基本不变,定量精度没有因为多鉴定而牺牲
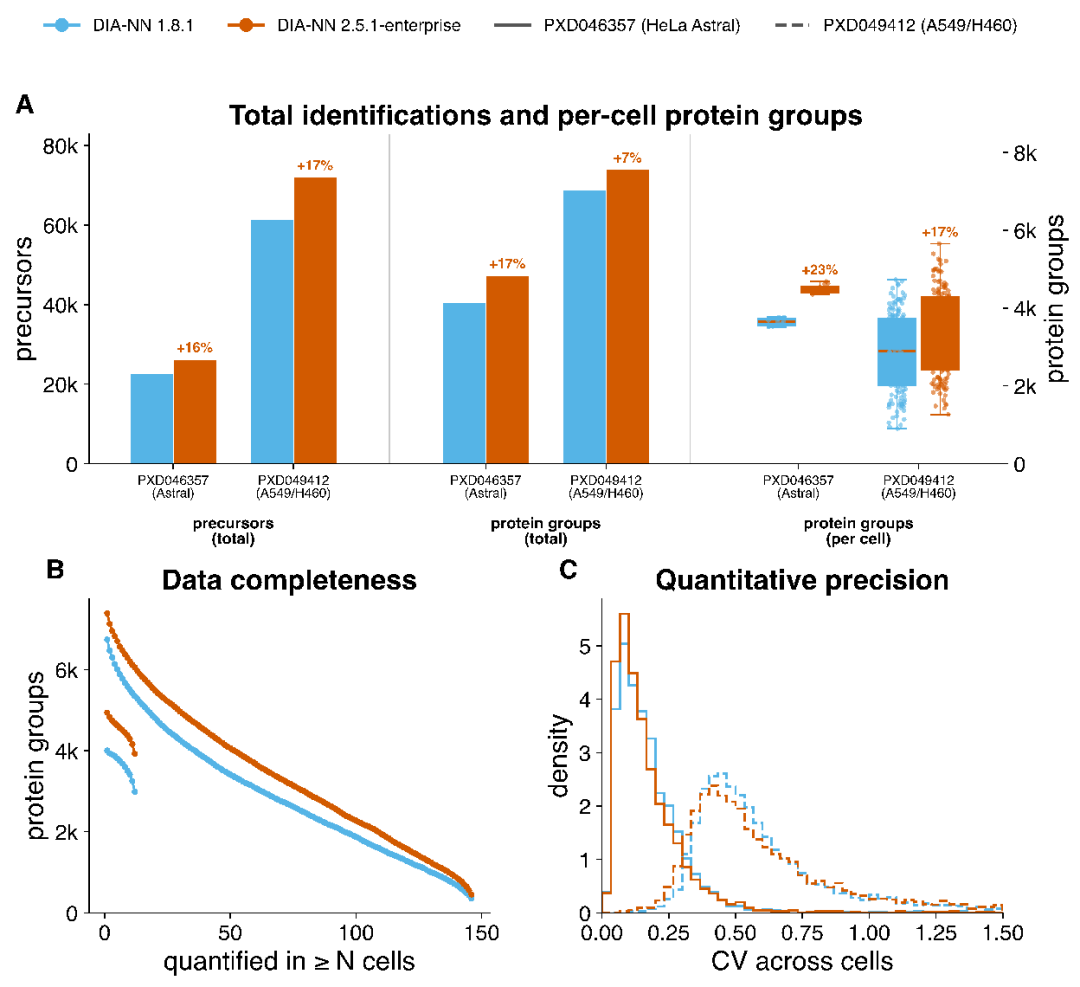
▲ 图3. DIA-NN 1.8.1 与 2.5.1-enterprise 在单细胞数据上的对比:总鉴定数、数据完整性与定量精度。
4. 重跑公共数据:老数据里的新蛋白
最有意思的部分是对已发表公共队列的重分析。作者把 NCI-60、ProCan-DepMapSanger、Sun PCT-SWATH、HeLa Astral 和 Spatial Deep Visual Proteomics 五个队列用同一套 SDRF 参数重跑了一遍:
- NCI-60(原 OpenSWATH):蛋白组 4,284 → 6,812,提升 59% - Sun PCT-SWATH(原 OpenSWATH):蛋白组 6,183 → 8,304,提升 34% - ProCan(原 DIA-NN 1.7):蛋白组 6,698 → 8,993,提升 34% - HeLa Astral(原 DIA-NN 1.8.1):蛋白组 4,137 → 4,840,提升 17% - Spatial DVP(原 DIA-NN 1.8.1):蛋白组 2,947 → 3,301,提升 12%
这说明:引擎越旧、原始分析越早,重分析能回收的蛋白就越多。对于用 OpenSWATH 或 DIA-NN 老版本处理的早期队列,重跑一次的收益最大。
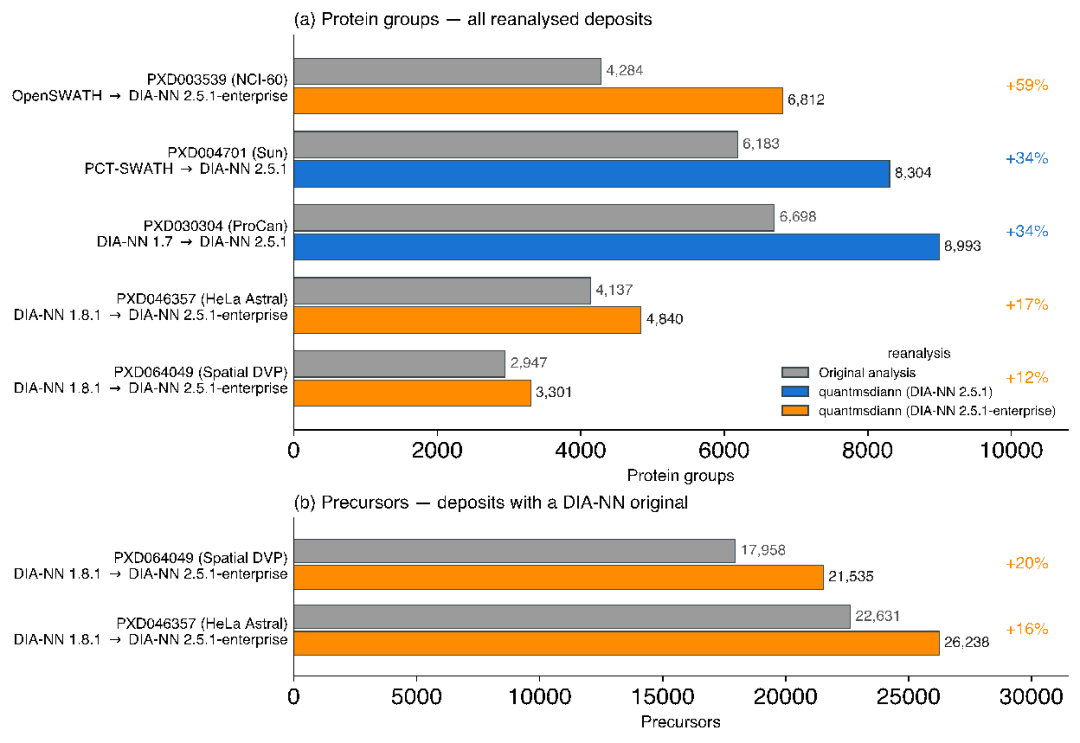
▲ 图4. 五个公共 DIA 队列的原始发表结果与 quantmsdiann 重分析结果对比。a 为蛋白组数;b 为 precursor 数。
5. 为什么这对我们有用?
数据不再是一次性消耗品
:PRIDE / iProX 里的 DIA 数据可以被统一、可重复地重分析。 元数据即分析参数
:SDRF 既是实验设计记录,也是工作流输入,后续想换版本、换参数、加样本都不用手动重写命令行。 输出格式直接下游可用
:除了 DIA-NN 原生报告,还输出 MSstats 输入表、QPX Parquet 归档和 pMultiQC 质控报告,可直接对接差异分析、批次校正、单细胞分群。 开源社区驱动
:代码托管于 https://github.com/bigbio/quantmsdiann,MIT 协议,文档见 https://quantmsdiann.quantms.org/。
结语
quantmsdiann 把 DIA-NN 从“单机桌面软件”变成了“可扩展、可复现、版本锁定的 HPC 工作流”。它的价值不只是跑得快,而是让公共 DIA 数据真正变成可反复查询、可跨研究整合的活资源。对于已经积累了大量 DIA 原始数据的实验室,用最新引擎统一重跑一遍,很可能是性价比最高的“数据再挖掘”方式之一。
参考来源:Yue Q-X, Shen Y, Dai C, et al. quantmsdiann: a scalable SDRF-driven DIA-NN workflow for reanalysis of single-cell, spatial, and bulk proteomics datasets. Research Square preprint, 2026. DOI: 10.21203/rs.3.rs-10319687/v1