
 English
人体与癌症蛋白质组空间图谱,DIA-MS重新定义人体蛋白地图
一句话看懂:西湖大学郭天南团队用DIA-MS对2,856例样本进行蛋白质组全景扫描,绘制出覆盖13,609个蛋白、58种正常组织+25种癌的人体空间蛋白地图,为靶点发现、药物重定位和器官毒性预测提供了统一数据底座。这项技术路线与临床蛋白质组服务高度同构,值得做质谱检测的老师同学重点参考。
一、为什么要再画一张“人体蛋白地图”?
蛋白质是细胞功能的最终执行者,也是绝大多数药物的直接靶点。但过去我们依赖转录组(RNA)推测蛋白表达,而mRNA与蛋白丰度的相关性只是中等。抗体方法(如HPA)虽然能定位,但半定量、抗体质量参差不齐,对低丰度蛋白力不从心。
质谱(MS)提供了一种无偏向、高通量的替代方案。2014年的两项MS草案首次覆盖了约85%的人类基因编码蛋白,但组织类型有限。最新的这项Nature研究把组织覆盖度、定量深度和病理状态比较一次性拉满,核心差异可以概括为三点:
- 组织最全:58种主要组织、251种具体亚型,涵盖几乎所有实体组织、体液和主要癌种。 - 状态最齐:胎儿(F)、健康成人(N)、肿瘤(T)、配对癌旁(NT)四种生理/病理状态同台比较。 - 技术最稳:统一采用DIA-MS(数据非依赖采集),3,005个DIA文件,蛋白水平FDR控制在0.1%。
二、研究是怎么做的?
团队收集了2,856例样本,来源包括:9例遗体捐献成人、8名健康志愿者、9例胎儿遗体,以及1,015例癌症患者。先构建了一个包含15,332个蛋白群的DDA光谱库,再用DIA-MS对实际样本进行定量,最终在3,005个MS文件中稳定定量到13,609个蛋白。
技术平台用的是Bruker timsTOF Pro,结合diaPASEF模式。FFPE样本经过脱蜡、碱水解、压力循环辅助裂解(PCT)、LysC/胰酶酶解、C18除盐和高pH反相分馏,最终10个组分上机。血液和体液样本则根据基质特点定制了Top14高丰度蛋白去除、特殊裂解等处理流程。整个流程标准化程度高,批次效应小,生物学重复的相关性也很高。
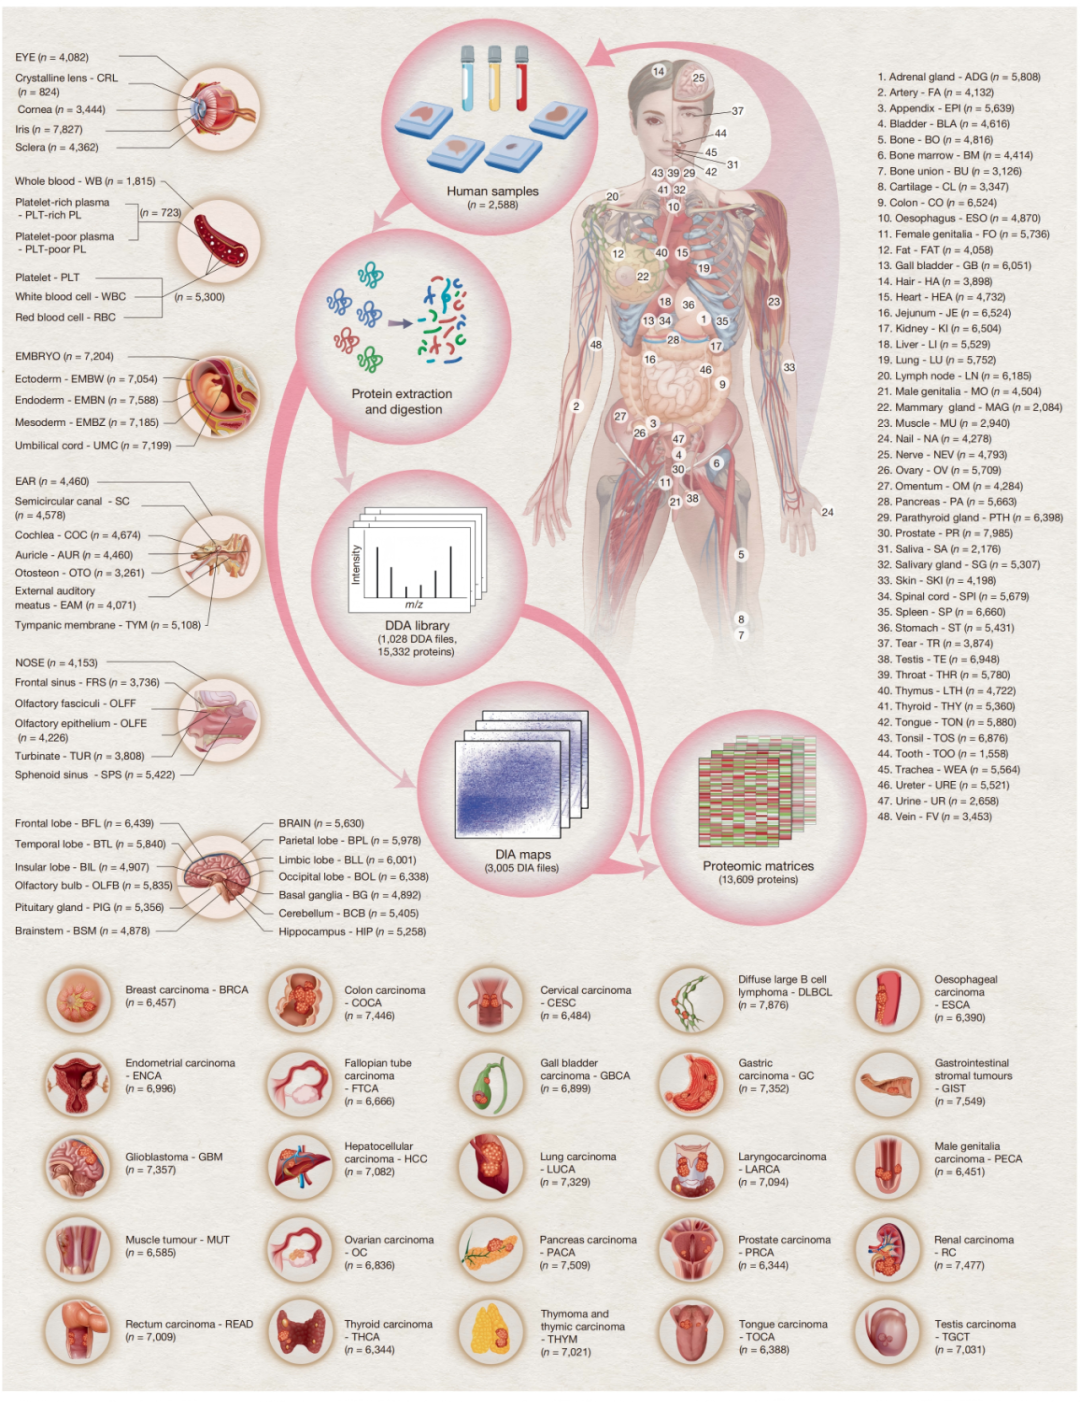
▲ 图1 人体蛋白地图样本概览:覆盖眼、耳、鼻、脑、血液、胚胎组织、多种实体器官及25种癌;每个组织标注了可稳定定量的蛋白数量。
三、四大核心发现
1. 从胎儿到肿瘤,蛋白组呈现清晰的分化轨迹
t-SNE分析显示,所有样本沿着t-SNE 1轴呈现F→T→NT→N的有序排列,正好对应组织分化程度。胎儿最“原始”,肿瘤偏离最大,癌旁居中,正常成人最“成熟”。
但有两个例外:
- 脑组织:脑肿瘤和癌旁脑组织聚类紧密,恶性转化过程中蛋白组异常稳定,反映了神经发育的功能约束。 - 肝脏:肝肿瘤和癌旁肝组织远离胎儿肝脏,提示肝脏对环境应激具有高度可塑性。
无监督聚类进一步识别出8个协同表达模块:
- 模块3(F高N低):富集RNA剪接,提示剪接调控在发育和肿瘤发生中的双重作用。 - 模块8(F低N高):富集体液免疫,反映胎儿和肿瘤样本中体液免疫被抑制或不完全。
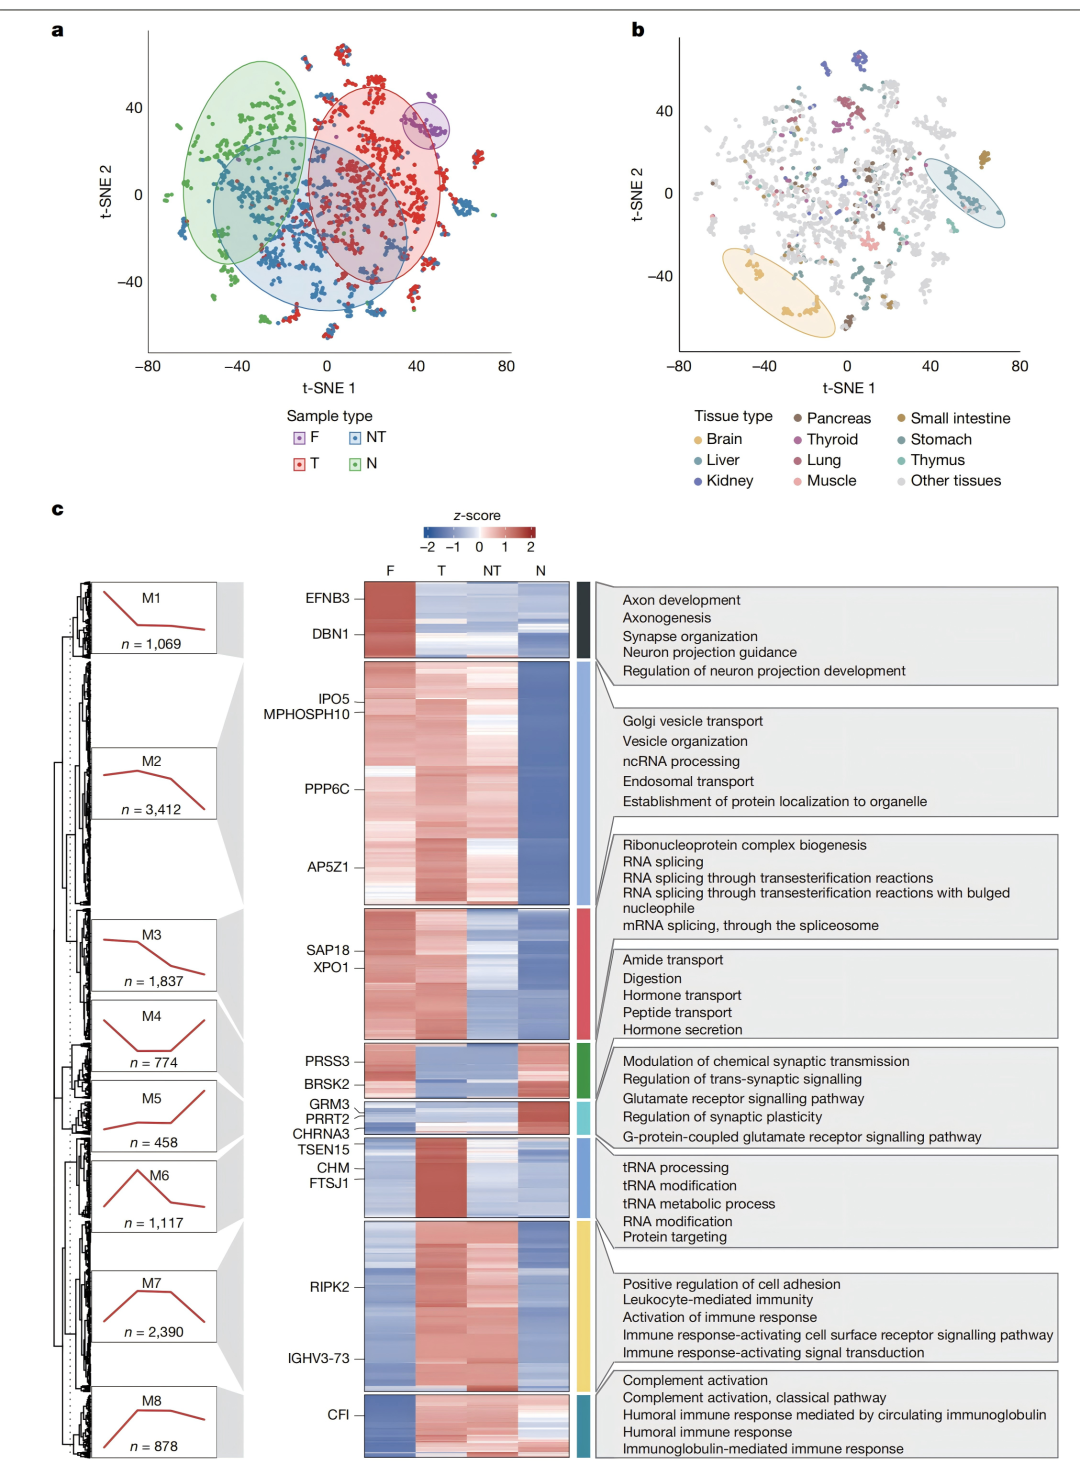
▲ 图2 组织发育与癌变的蛋白组转化轨迹:a/b为t-SNE聚类;c为8个共表达模块及对应功能注释。
2. 组织特异性蛋白与成药靶点的空间分布
研究用HPA标准把蛋白分为六类:未检出、组织富集、组富集、全组织表达、组织增强、混合。共鉴定出1,717个组织富集蛋白,其中480个来自以往研究覆盖不足的24种组织。
关键亮点:
- 脑含有最多的组织富集蛋白;晶状体的组织富集蛋白占总鉴定蛋白的比例最高。 - 在36种与HPA重叠的组织中,832个蛋白是本研究独有的组织富集蛋白,122个仅在HPA RNA中富集,666个在蛋白水平得到验证。 - 一个有意思的发现:PANX3被注释为HPA中“未检出”,但本研究将其鉴定为耳蜗最富集的蛋白。
这些组织特异性靶点的空间分布,为解释药物器官毒性提供了分子参考:如果某个药物靶点在肝脏或心脏高度富集,就要警惕相应毒性。
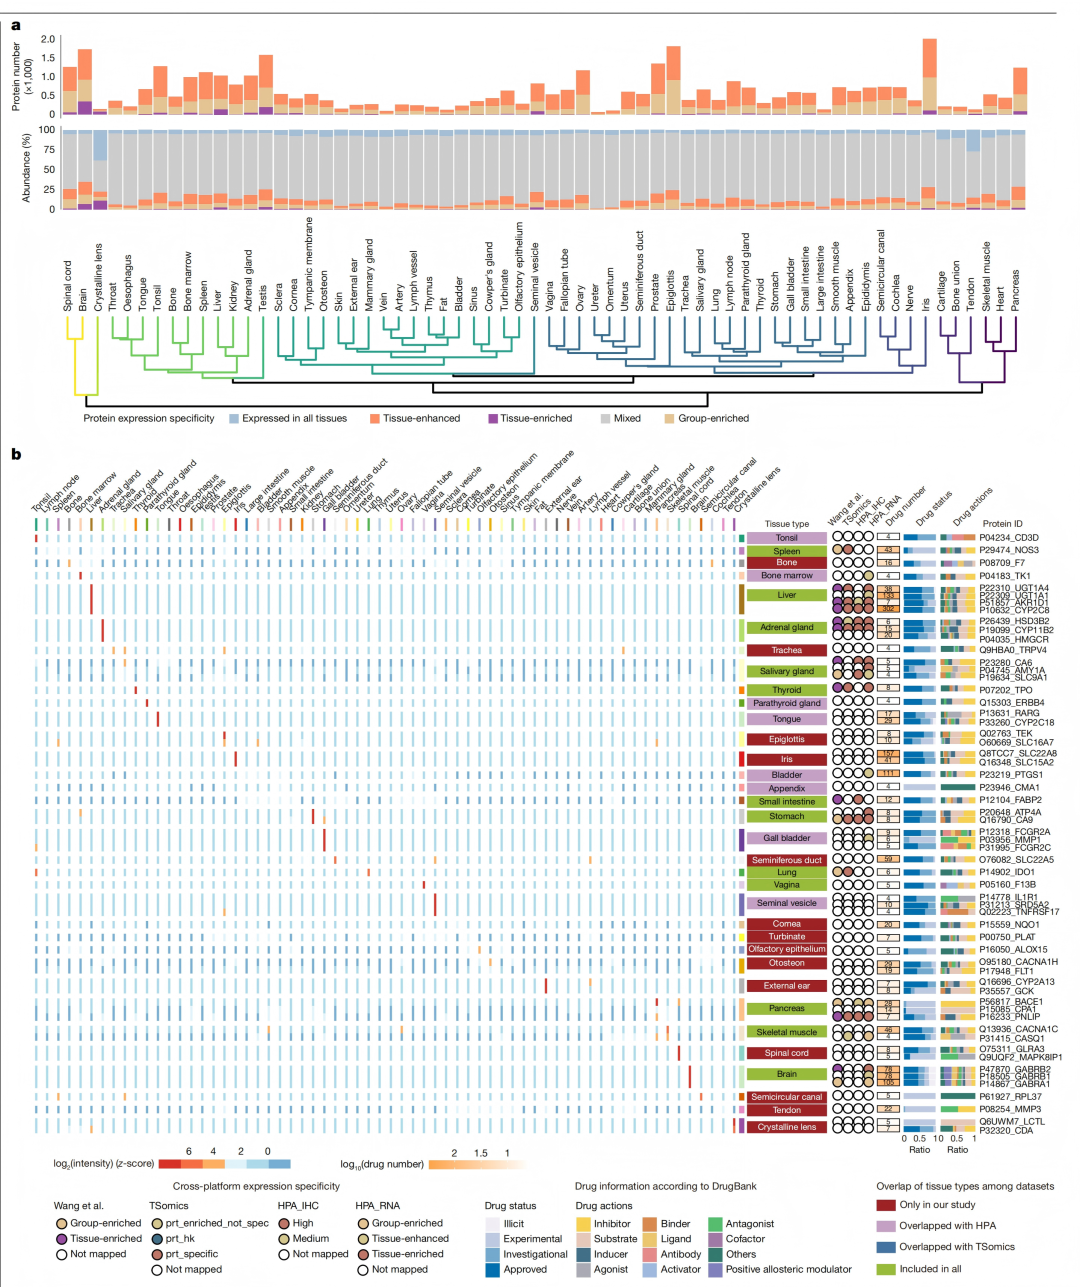
▲ 图3 组织特异性蛋白与药物靶点:a为各组织蛋白特异性分类;b为跨平台比较的组织特异性药物靶点热图。
3. 肿瘤特异性蛋白标志物与PRM验证
研究鉴定了各类癌症的肿瘤特异性差异表达蛋白(DEPs)、局部差异表达蛋白(LEDEPs)和肿瘤富集蛋白。以DLBCL(弥漫大B细胞淋巴瘤)为例,PAX5被确认为肿瘤特异性且肿瘤富集的蛋白,PRM靶向验证与DIA结果一致。PAX5维持B细胞身份并抑制终末分化,与BTK抑制剂联用可能增强疗效。
另外两个膜蛋白值得关注:
- TYROBP:在结直肠、胃、肾、胰腺等10种癌中肿瘤富集,是潜在的共享ADC靶点,但需评估其髓系表达带来的毒性。 - KIT:GIST特异性且GIST富集,提示靶向异常ICC样信号的治疗潜力。
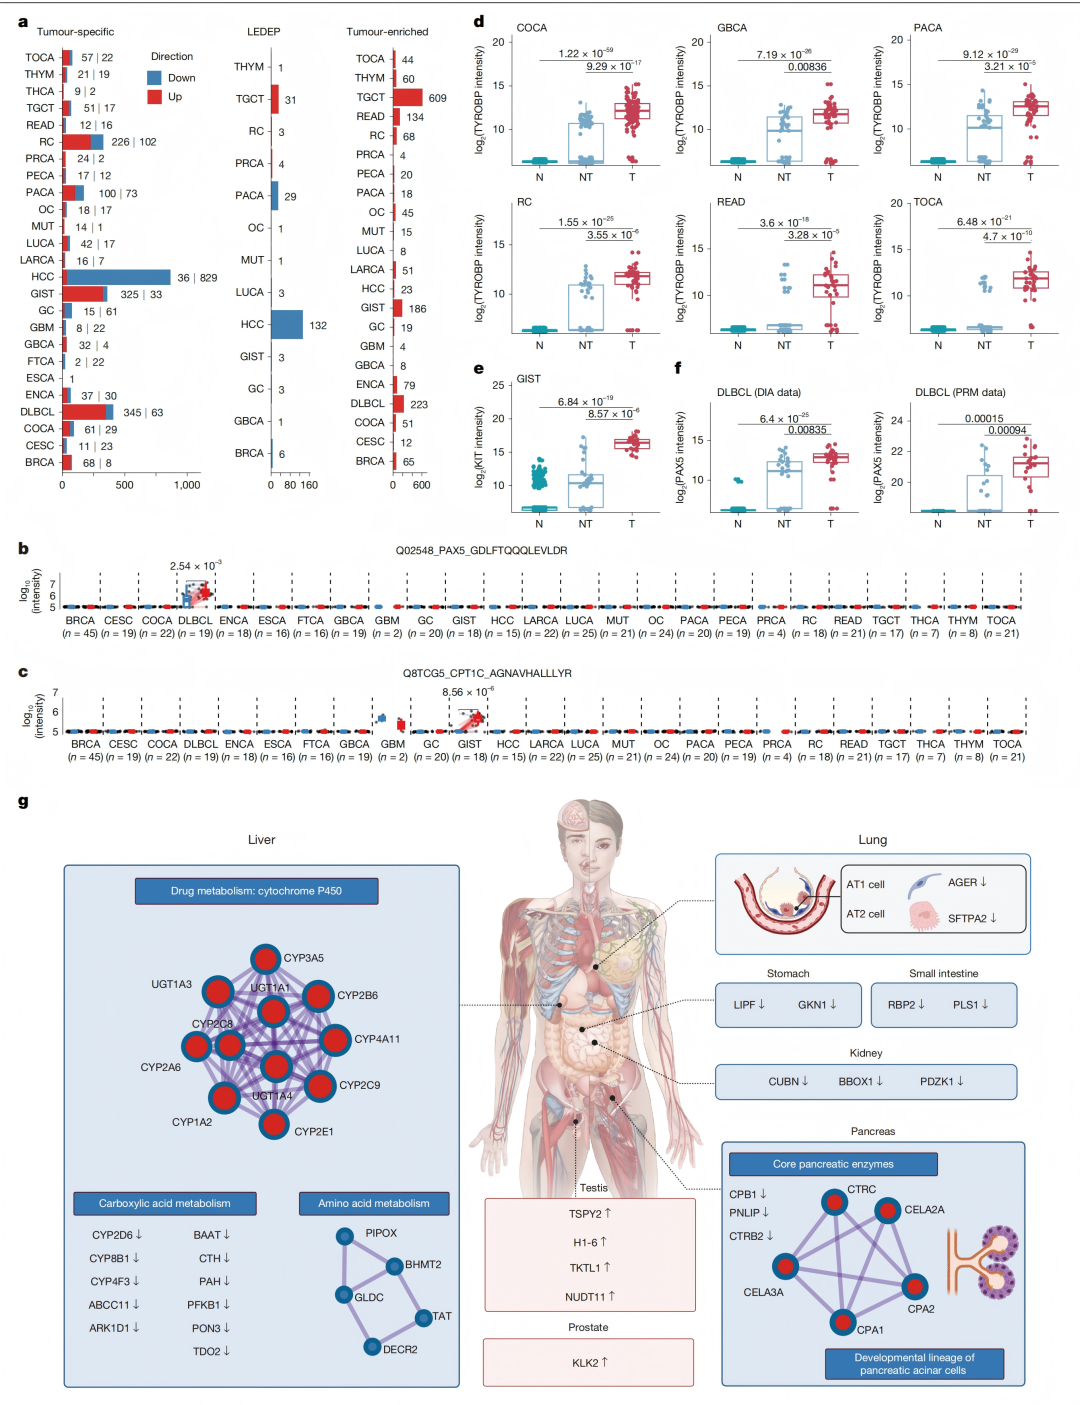
▲ 图4 肿瘤特异性蛋白标志物:a为各癌种DEP/LEDEP/肿瘤富集蛋白数量;b-f为PAX5、CPT1C、TYROBP、KIT等关键蛋白的验证与表达;g为器官特异的癌症LEDEP系统视图。
4. 药物重定位与候选靶点
研究团队把上调DEPs与ProCan-DepMapSanger数据集、CRISPR-Cas9基因必需性数据整合,筛选出35个药物-蛋白对,覆盖9个DEPs,大多为受体酪氨酸激酶(RTK)。
两个典型案例:
- MET抑制剂:MET高表达与savolitinib、tepotinib、merestinib在结直肠癌细胞中的敏感性正相关;CRISPR也支持MET在直肠癌中的必需性。 - BCL2L1抑制剂:BCL2L1高表达与navitoclax敏感性相关。
重定位方面也给出新思路:
- Trodelvy(sacituzumab govitecan):靶点TROP2和TOP1在子宫内膜癌和乳腺癌均上调,提示可用于子宫内膜癌(已有II期试验支持)。 - Olaparib(PARP抑制剂):PARP1在多种妇科癌中上调,提示在子宫内膜癌、宫颈癌中的潜在价值。
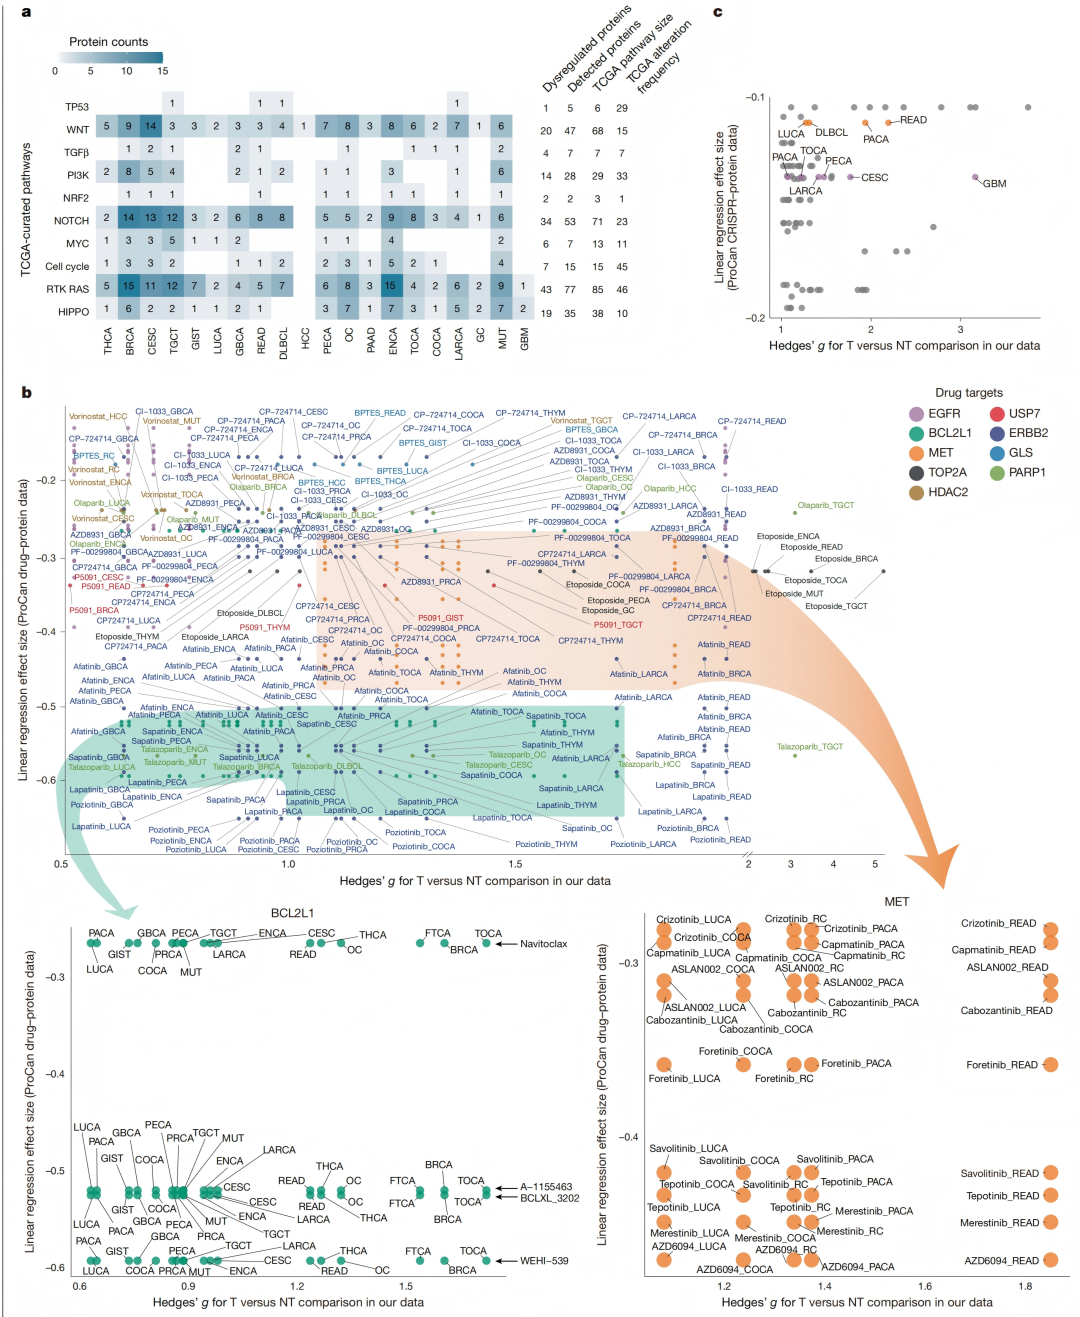
▲ 图5 潜在药物靶点与重定位:a为TCGA通路中各癌种失调蛋白数量;b/c为蛋白-药物、蛋白-CRISPR关联,突出MET和BCL2L1。
四、对蛋白质组学服务与临床研究的启示
这项研究不仅是一份数据资源,更是一套可直接借鉴的方法学模板:
- DIA-MS是大规模组织队列的首选:相比DDA和TMT,DIA在批次稳定性、定量完整性和样本通量之间取得了最佳平衡,特别适合临床FFPE样本库。 - DDA建库+DIA定量的“杂交策略”:先用少数样本做深度DDA分馏建库,再用大样本DIA定量,兼顾深度和通量。 - PRM是临床转化的关键验证:从发现到靶向验证,DIA→PRM的闭环能增强结果可信度,也便于后续开发伴随诊断。 - 数据整合提升价值:把蛋白组与DepMap药物敏感性、CRISPR必需性、TCGA通路信息打通,才能从“差异列表”走向“可成药假设”。
五、数据资源与局限
研究团队开放了交互式数据库:https://db.prottalks.com/,支持蛋白中心查询、组织中心查询和在线差异分析。原始数据已上传ProteomeXchange/iProX(PXD077178, IPX0003578000)和PRIDE(PXD063370)。分析代码见GitHub:guomics-lab/TPHP。
局限也需要正视:正常样本主要来自老年捐献者,某些组织(如乳腺)受年龄相关萎缩影响;毛发、体液等特殊样本使用专门处理方案,跨组织比较时需谨慎;每个癌种约40例患者,样本量限制了患者间异质性的刻画。
六、结语
如果说2014年的“人类蛋白组草案”回答了“人体能检测到多少蛋白”,那么这项Nature研究回答的是“这些蛋白在人体不同空间和病理状态下如何分布”。13,609个蛋白、2,856例样本、四种生理病理状态、跨癌种比较,构成了一个真正意义上的“人体蛋白数字导航仪”。对于从事临床蛋白质组学、肿瘤靶点发现和药物重定位的研究者来说,这既是数据金矿,也是方法学标杆。