
 English
单细胞分析总漏掉稀有细胞?DR-GEM让AI向自己的错误学习
核心结论:斯坦福Jerby组在Nature Communications发表DR-GEM框架,直指单细胞分析的隐痛——标准降维聚类流程会把"样本量多"当成"重要",稀有细胞(占比低至0.1%)因此被嵌入错位、聚类吞并、标注张冠李戴。DR-GEM用重构误差(RE)做自监督信号,让模型先发现自己的盲区,再通过平衡共识学习反复"补课"。实测中,稀有细胞标注准确率从标准流程的0%提升到88%-98%;卵巢癌空间转录组中占比0.397%的肥大细胞被成功单列成簇;43位患者中9位"沉默"的恶性细胞状态被找回,还揪出一个病理医生确认的形态学亚克隆。方法以R包开源,值得每一位做单细胞、空间组学和Perturb-seq的同行关注。
我们先从一个所有做过单细胞分析的人都见过的场景说起:UMAP图上,绝大多数细胞形成漂亮的分型色块,但总有几小撮细胞散落在边缘——它们是谁?是噪声,还是被算法淹没的真正稀有细胞类型?
Nature Communications 最新在线发表的研究给出了一个扎心的答案:很多时候不是数据不够,而是算法默认了"多即是重要"。
稀有细胞的"沉默成本":标准流程的系统性盲区
研究团队用合成数据把这个问题量化到了极致。他们构建了含5种细胞类型的模拟数据集(21,550个细胞),丰度从8000、5000、4500、4000一路递减到只有50个细胞的第5类——占比0.23%,模拟真实组织中的稀有细胞类型。
跑一遍标准流程(PCA降维→UMAP可视化→Louvain-SNN聚类),结果一目了然:
- 稀有细胞的重构误差(RE)显著高于其他细胞,且在RE分布右尾中被系统性富集——RE本质上是模型"重建这个细胞失败的程度",数值越高说明模型越没把它学明白; - 在800个稀有细胞比例递减(从15.67%降到0.12%)的模拟数据集中,这一富集模式稳定出现; - 更糟的是,聚类时稀有细胞无法形成自己的簇,被硬生生拆散安插进其他细胞类型,标注准确率归零。
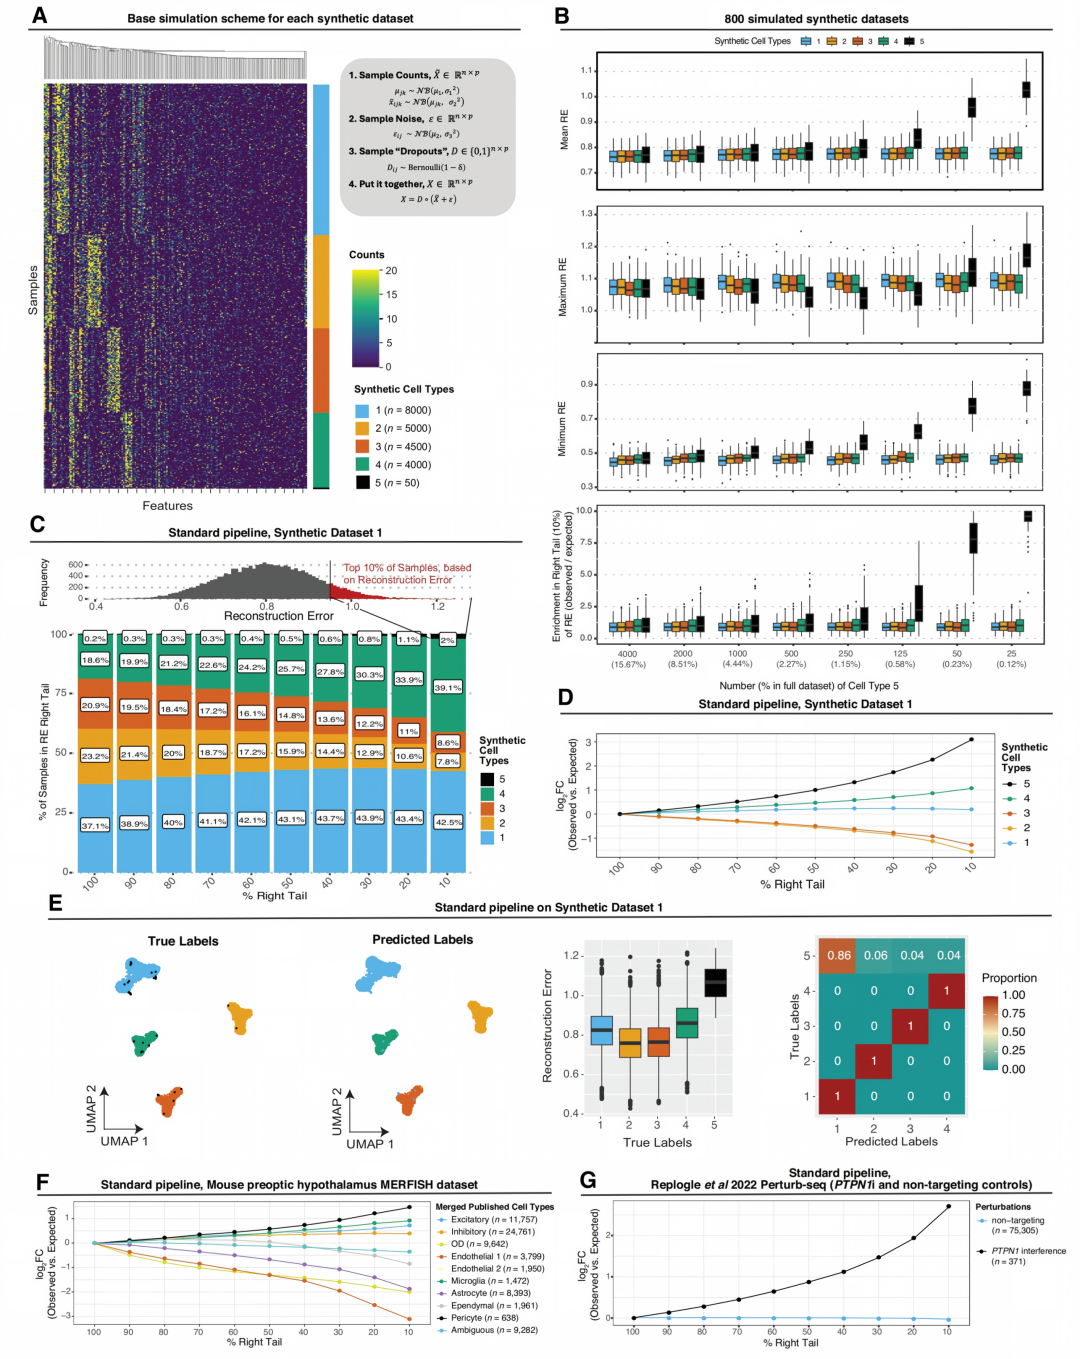
▲ 图1|稀有/罕见细胞在标准单细胞分析流程中嵌入不良且易被错误标注。A为合成数据生成方案;B显示800个递减丰度模拟数据集中稀有细胞的RE持续偏高;C-E展示RE右尾富集与聚类错标;F-G将同一现象复现于小鼠下丘脑MERFISH与Perturb-seq真实数据。
关键洞察在这里:RE右尾富集的是"类别不平衡"本身,而不是测序质量差。团队进一步模拟了环境RNA污染、低读数细胞(20%)和批次效应(20%)三种技术噪声,发现这些"坏细胞"反而在RE右尾中是缺失的——也就是说,RE升高的主因是稀有,不是噪声(所有噪声数据集中p<4×10⁻¹⁴)。这为后续用RE定位稀有细胞提供了干净的理论依据。
现有补丁不管用:DRO与公平性算法为何失效
"分布鲁棒优化(DRO)"和"公平性学习"本是为不平衡数据设计的,那直接用它们改造PCA行不行?作者测试了三种代表方法(图2):
- KL-DRO(KL散度约束)与CVaR-DRO(条件风险价值)目标下求解PCA:调遍超参数,稀有细胞的RE依旧高企,聚类照样错标; - Tilted Fair PCA:能把稀有细胞与多数细胞的RE差距稍微拉近(但p=1,不显著),依然无法让稀有细胞独立成簇。
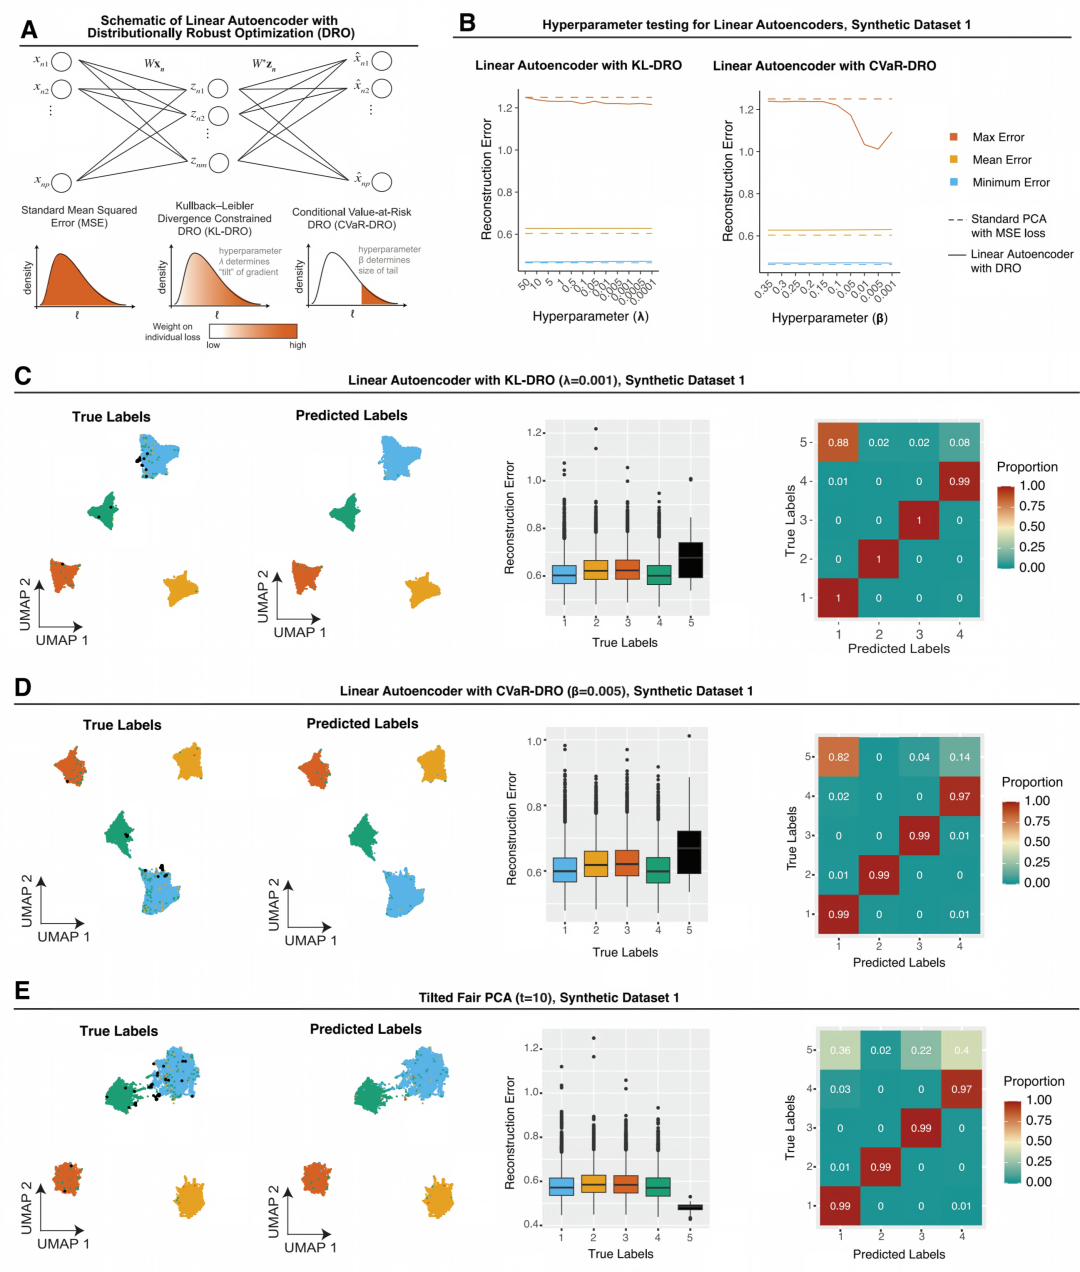
▲ 图2|现有DRO与公平性感知算法并不能改善稀有细胞的嵌入与检测。A为KL-DRO与CVaR-DRO优化PCA的示意图;B-E展示三种方法在合成数据上的表现,稀有细胞仍被错误标注。
问题的根子在于:这些方法只调损失函数的权重,但聚类环节依然在同一张"多数派主导"的嵌入图上进行。稀有细胞的信号没有被真正"翻案",只是被轻描淡写地减了刑。这正是DR-GEM选择另起炉灶的原因。
DR-GEM的解法:让模型从自己的错误中学习
DR-GEM(Distributionally Robust and latent Group-AwarE consensus Machine learning)是一个自监督元算法——它不发明新的降维方法,而是在任何现成方法(PCA、Kernel PCA、LDA、scVI皆可)外面包一层"错误驱动的补课机制"。全流程分四个阶段:
- Phase I|分布鲁棒初始化:先用标准方法(默认PCA)对全部细胞做嵌入,计算每个细胞的RE;取RE最高β分位(默认5%)的"高危细胞",单独在这个子集上重新拟合一个初始嵌入E(init),再把所有细胞投影进去做聚类,得到初始"弱标签"。这一步的本质是把模型的注意力强行拉到它原来学得最差的地方。 - Phase II|平衡共识学习:从弱标签出发,抽取r次"每类等额"(默认每簇500细胞)的平衡子样本,分别独立嵌入+聚类;不同轮次之间的簇标签用Kuhn-Munkres(匈牙利)算法对齐。稀有细胞在每一轮子样本中都不再是"零头",而是与多数派平起平坐。 - Phase III|聚合与高置信参考图谱:对r轮预测做多数投票得到最终标签;每个细胞获得置信度分数s(它被分到最终簇的轮次比例)。高置信细胞(默认s>0.95)用来构建"参考嵌入",全部细胞再投影其上。低置信分数还能反过来标记可疑细胞——实测中被错误标注的细胞、被环境RNA污染的细胞,置信度都显著更低。 - Phase IV(可选)|签名注释:用已知基因签名(signature)的总体表达(OE)自动把簇映射到细胞类型,为端到端注释闭环。
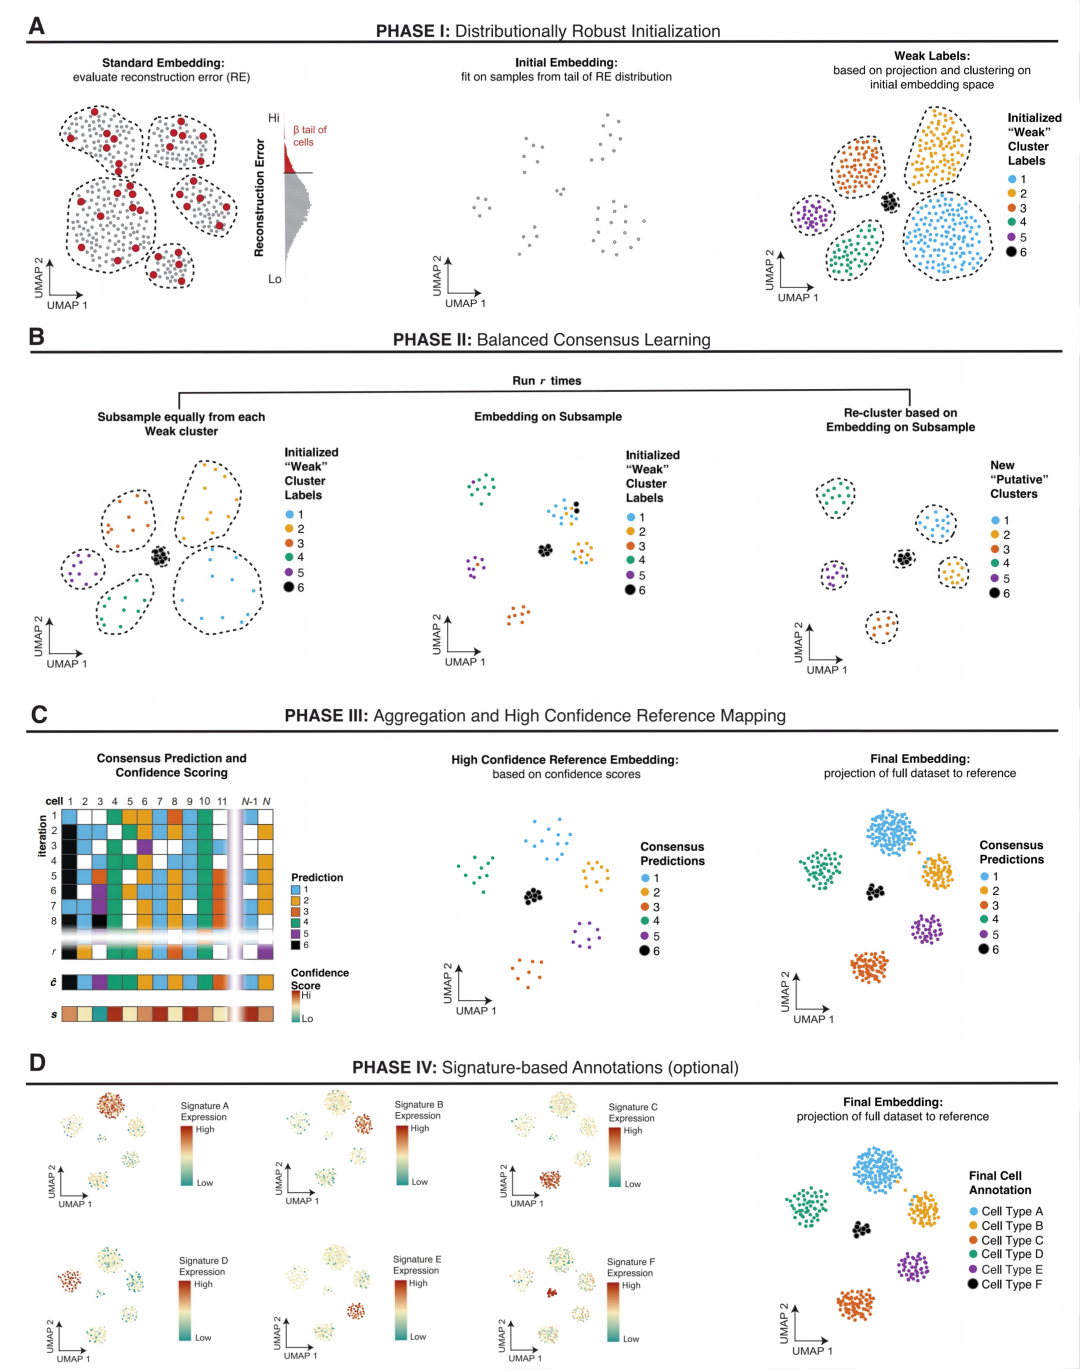
▲ 图3|DR-GEM是用于降维与聚类的自监督元算法。A-C分别对应Phase I-III:RE定位高危细胞→平衡子采样集成→共识聚合与高置信参考图谱;D为可选的签名注释(Phase IV)。
这个设计嫁接了监督学习里三个经典思想的精髓:分布鲁棒优化、难例挖掘(hard-example mining)和boosting——让模型检测并学习自己的错误,只不过整个回路不需要任何标签。
合成数据实测:稀有细胞检出率从0%到98%
战绩说话(图4-5):
- 基础战场(Synthetic Dataset 1):标准流程对稀有细胞标注准确率0%;DR-GEM让稀有细胞独立成簇,准确率98%,且各类细胞RE被拉平(p=0.78)。 - 加环境RNA(Synthetic Dataset 2):DR-GEM对稀有细胞标注准确率88%(标准流程0%);对被污染细胞整体标注正确率86.9%,只看高置信细胞(s>0.95)时达99.0%(标准流程84.3%);被污染的稀有细胞正确率64.7%对标准流程的0%。 - 加低读数/批次效应:稀有细胞检出率分别98%和96%,标准流程两种场景下全军覆没(0%)。 - 多类稀有细胞(Synthetic Dataset 3,5种稀有类型各50个):DR-GEM让全部5种稀有类型各自成簇,每种类型标注准确率90%-98%(标准流程再次0%)。 - 与需要标签的方法组合:DR-GEM+SMOTE能达到100%准确率,但会扭曲稀有细胞群的表达景观(把均一群体虚假地表现为高度异质);DR-GEM+类加权PCA减了RE差距却仍错标——DR-GEM独立使用反而更稳。
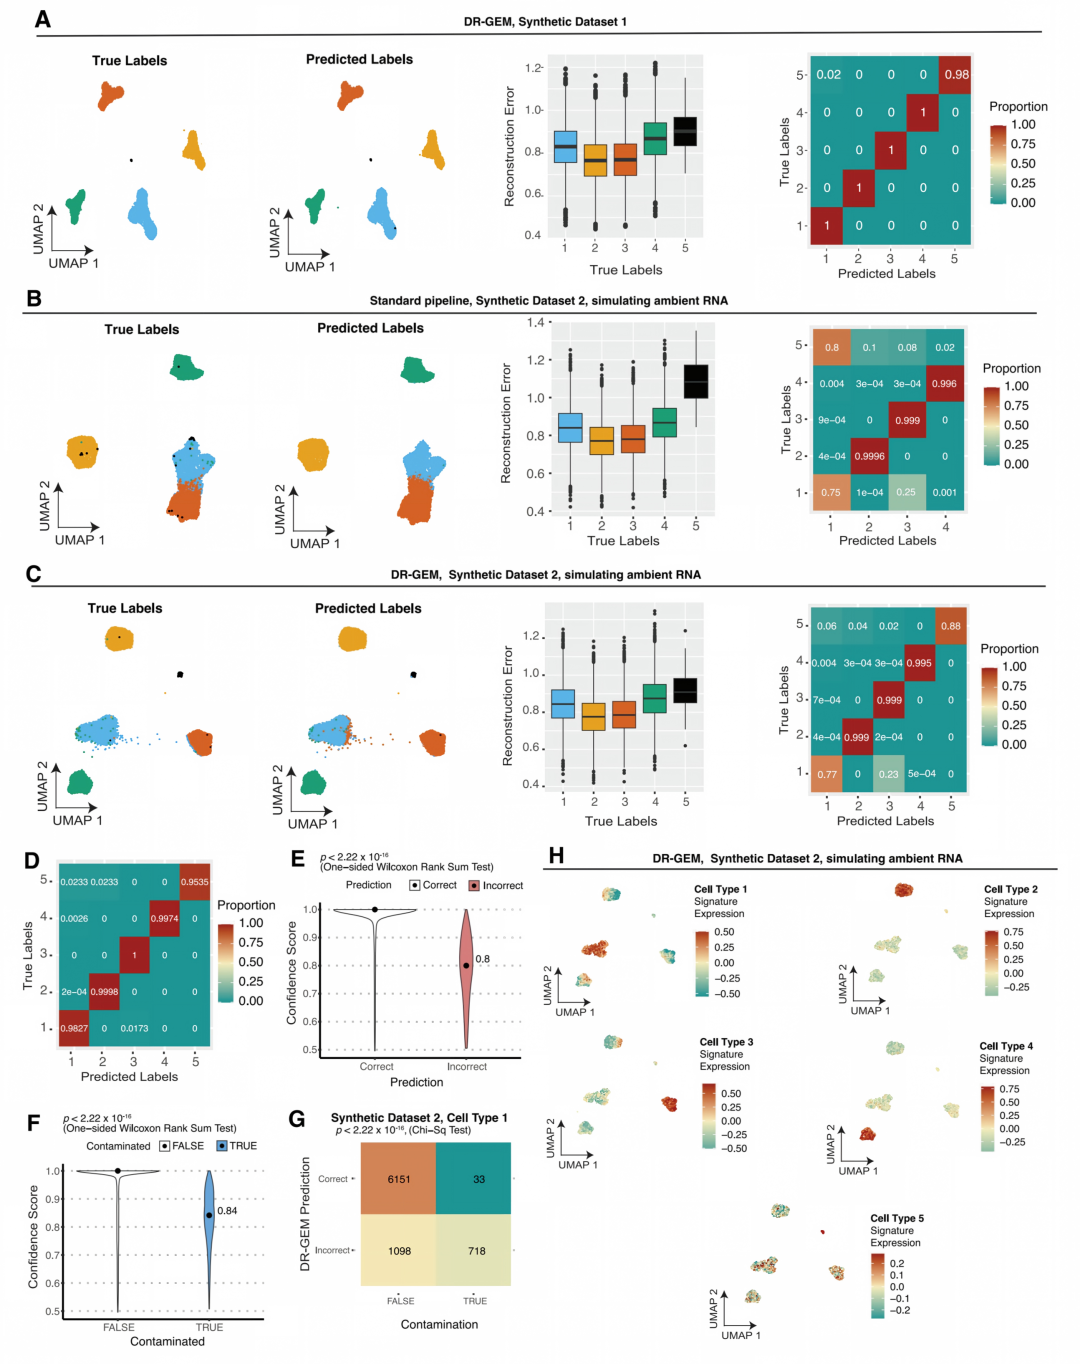
▲ 图4|DR-GEM在合成数据集上优于替代方法,改善稀有细胞的嵌入与标注。A-C对比有无环境RNA时标准流程与DR-GEM的聚类及混淆矩阵;D-H展示置信分数如何识别错标与污染细胞。
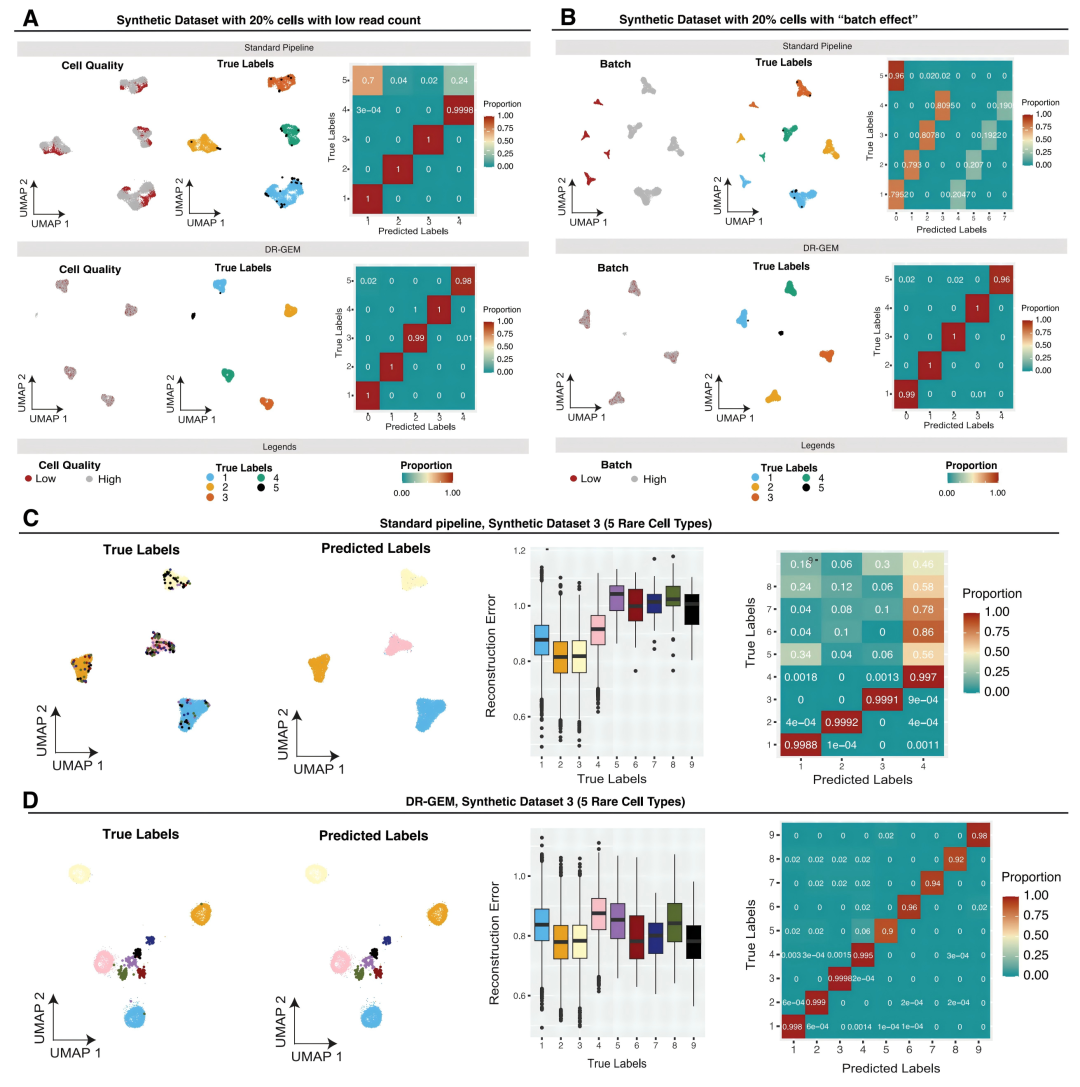
▲ 图5|DR-GEM在含技术噪声与多类稀有细胞的模拟数据上表现出色。A-B为20%低读数与20%批次效应场景;C-D为含5种稀有细胞类型的数据集,DR-GEM全部正确分型。
同样一套机制还能与Kernel PCA、LDA、scVI(VAE)等不同底座组合,稀有细胞改善一致复现——说明这层"错误驱动补课"是方法无关的通用外挂。
真实考验一:卵巢癌空间转录组,0.397%的肥大细胞现形
合成数据终究是理想国。团队把DR-GEM放到高级别浆液性输卵管卵巢癌(HGSC)的CosMx单分子成像(SMI)空间转录组数据上——82,808个非恶性细胞,其中肥大细胞(Mast cells)仅占0.397%(329个),且数据带有明确的背景RNA污染。
标准流程的表现:肥大细胞在嵌入图中四散漂泊、无法成簇,RE显著高于所有其他细胞类型(p=5.08×10⁻²⁰⁶);聚类-匹配后成纤维细胞96%、单核细胞97%、内皮细胞98%、T/NK细胞97%都能对上号,唯独没有任何一簇对应肥大细胞(B细胞也只有61%)。
DR-GEM的表现:肥大细胞独立成簇且RE与其他类型持平(p=0.303),全类型一对一匹配——成纤维93%、单核99%、内皮99%、B细胞78%、T/NK 95%、肥大细胞85%。在全部细胞(含恶性细胞、SMI+MERFISH两种平台)的注释闭环模式下,标准流程只能识别最丰的4类细胞,DR-GEM在SMI中识别全部7类、MERFISH中识别全部6类。
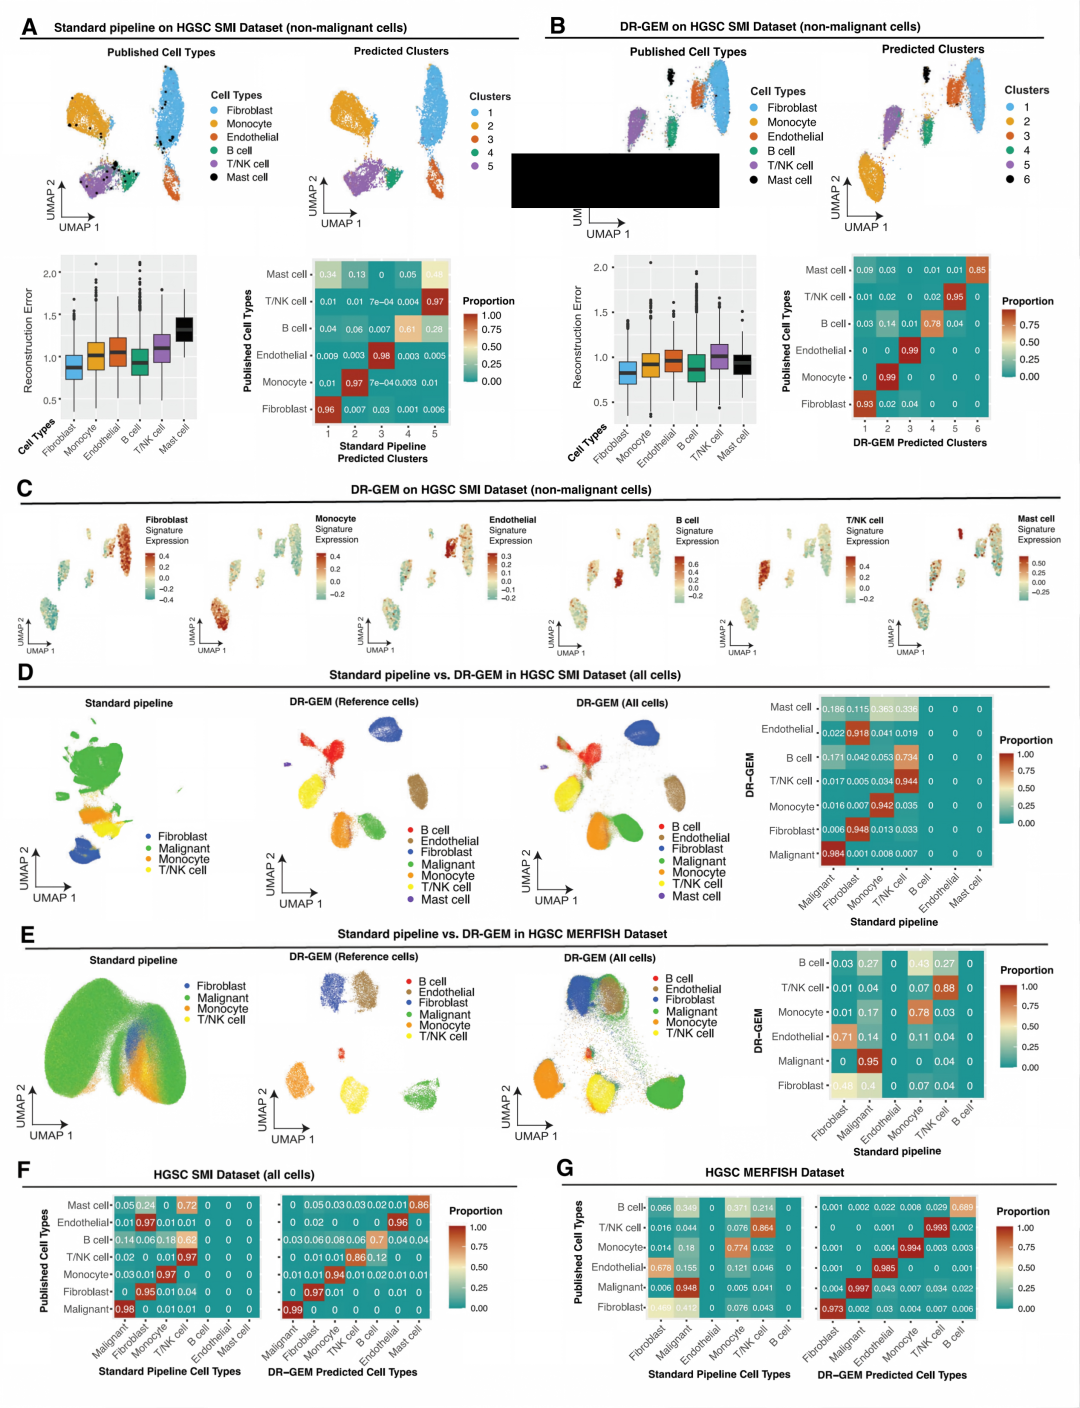
▲ 图6|DR-GEM在HGSC空间转录组中识别稀有细胞类型并缓解环境RNA影响。A-B对比标准流程与DR-GEM在非恶性细胞上的表现;C为高置信参考图谱;D-G展示全数据集(SMI与MERFISH)上DR-GEM检出全部细胞类型。
真实考验二:43位患者的恶性细胞,找回9位"沉默者"并揪出亚克隆
恶性细胞高度异质、常按患者聚类,是检验"患者级不平衡"的天然考场。团队对185,071个恶性细胞、43位患者的SMI数据施用DR-GEM(annotations-in-the-loop模式):
- 标准流程:44个患者特异性簇只覆盖34/43位患者——剩下9位患者在数据中占比不足1%,他们的恶性细胞状态被彻底吞没;占比最低的12位患者中仅3位拥有自己的簇。 - DR-GEM:39/43位患者拥有患者特异性簇,12位低代表患者中8位被找回。
更有说服力的是个案:某位患者DR-GEM分出3个簇(标准流程只有2个),其中仅DR-GEM检出的簇49(543个细胞,占0.29%)在空间上紧密聚集——经独立阅片的 board-certified 病理医生确认,它对应H&E染色上形态学截然不同的一个恶性亚克隆。算法先看见,病理再证实——这是"稀有≠噪声"最漂亮的实锤。
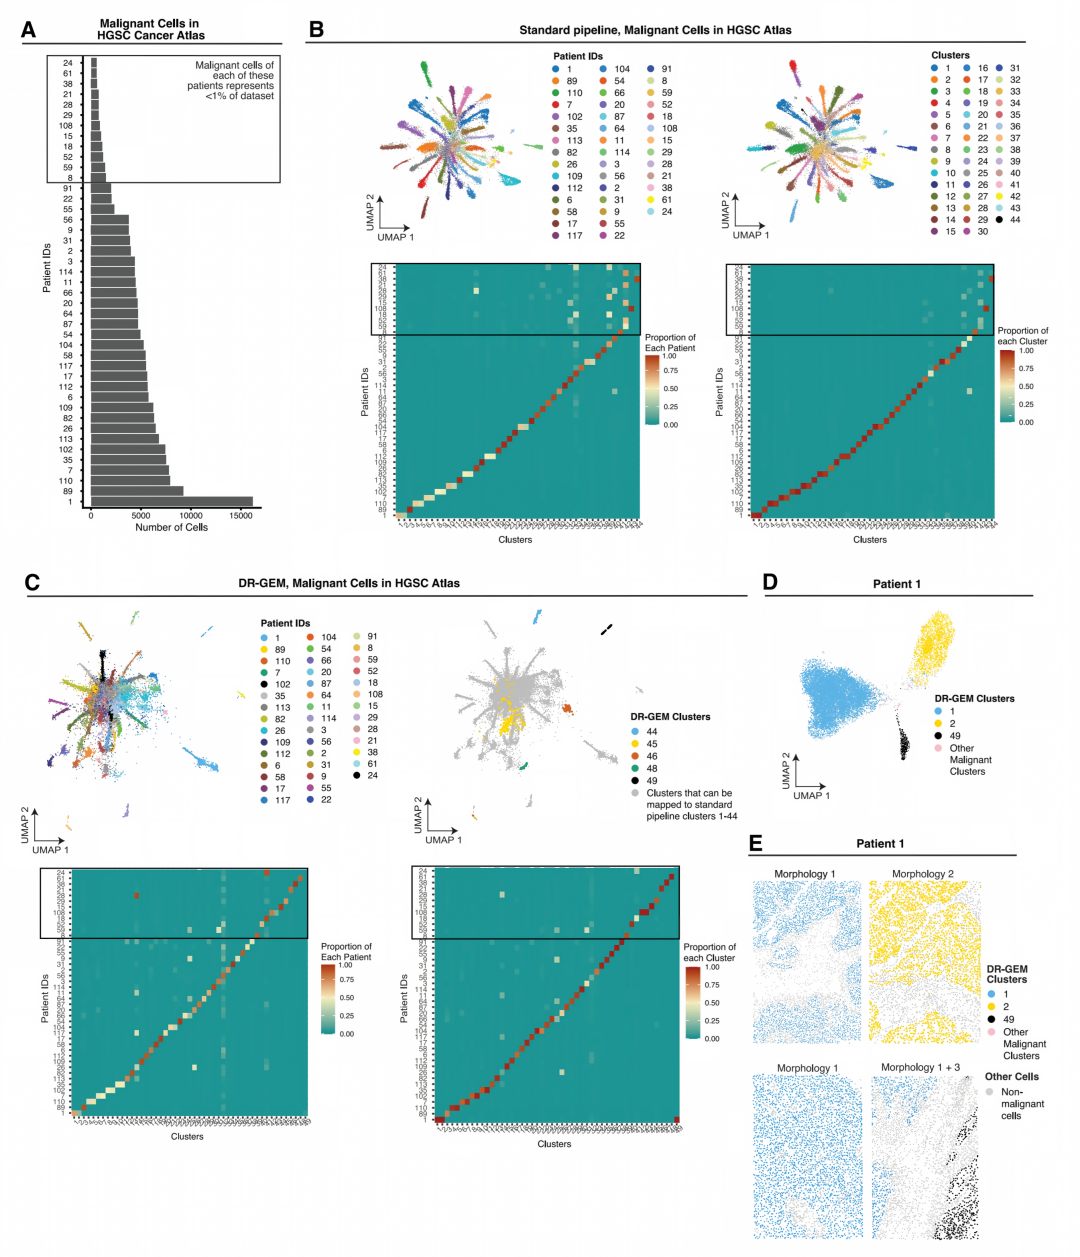
▲ 图7|DR-GEM改善稀有患者特异性恶性细胞的检测,并发现形态学上独特的恶性亚克隆。A为各患者恶性细胞数量;B-C对比标准流程与DR-GEM的患者覆盖;D-E展示簇49在空间上对应病理确认的亚克隆。
真实考验三:小鼠下丘脑MERFISH,周细胞从0%到79%
团队再用注释金标准数据加压:小鼠视前下丘脑MERFISH数据集(73,655个细胞,9种细胞类型+Ambiguous),最稀有的周细胞(Pericyte)仅占0.866%(638个)。
标准流程下,周细胞无法成簇、RE显著偏高(p=1.50×10⁻³),注释准确率为0%——没有任何一簇映射到周细胞。DR-GEM(注释闭环模式)下,周细胞独立成簇、RE拉平(p=0.45),注释准确率79%;其他类型也普遍保持或改善(星形胶质细胞94%、室管膜细胞98%)。
一个细节很能体现置信分数的价值:原研究标注为"Ambiguous"的9,282个细胞,DR-GEM虽把它们分入各类,但其置信度分数显著低于其他细胞(p=1.12×10⁻¹⁷⁷)——算法用分数诚实地标注了自己的不确定,这比硬给个答案珍贵得多。
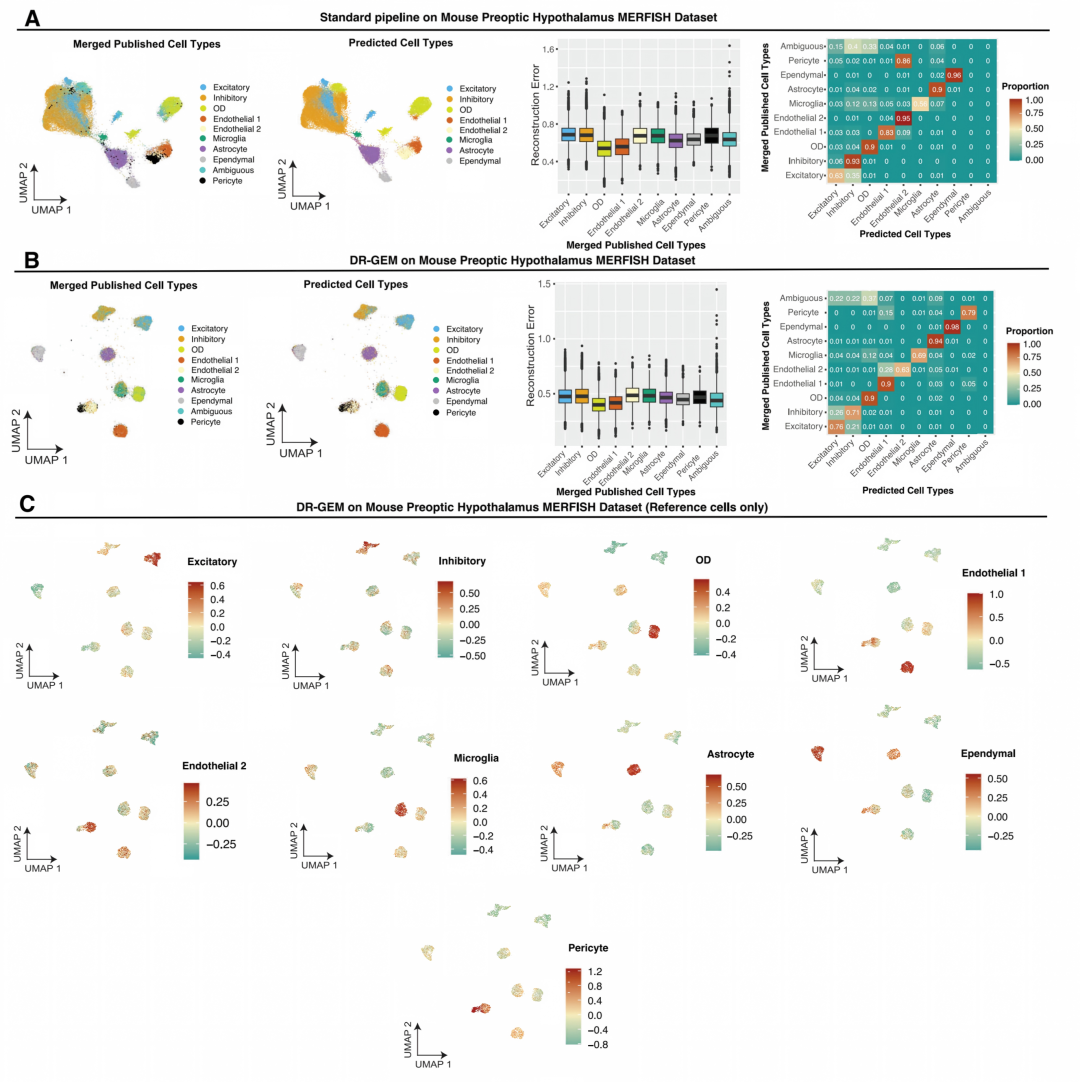
▲ 图8|DR-GEM在小鼠下丘脑MERFISH数据中识别稀有细胞类型并缓解背景RNA影响。A-B对比标准流程与DR-GEM,周细胞(0.866%)从无法成簇到独立成簇(79%准确);C为基于配对scRNA-seq签名的参考图谱。
真实考验四:Perturb-seq,从7.5万对照细胞里捞出371个扰动细胞
Perturb-seq是类别不平衡的重灾区:K562全基因组CRISPRi数据集中,非靶向对照(NTC)细胞多达75,305个,而单个扰动的细胞数从2到1,963不等。团队选取了6种转录影响强度不同的扰动做考验:PTPN1i(371个,占0.490%,1,844个DEG)、MED19i(299个)、SRRTi(100个)、MRPL24i(268个)、CASP8AP2i(211个)、NRDE2i(172个)。
以PTPN1i为例(图9):标准流程的UMAP上扰动细胞与对照连成一片"连续统";DR-GEM则给出两个边界清晰的簇,与扰动状态一一对应。量化到分类指标:DR-GEM准确率1.00、平衡准确率0.94、灵敏度0.89,全面碾压标准流程的0.93/0.85/0.77。
更耐人寻味的是生物学层面的发现:sgRNA检出阳性但被DR-GEM判为NTC的细胞,其PTPN1i扰动签名表达显著更低——很可能sgRNA虽在,功能干扰却没发生;反之,24%的低签名PTPN1i细胞中有59%仍被DR-GEM判为PTPN1i,说明DR-GEM捕捉到了标准差异表达分析捕捉不到的扰动效应。对MRPL24i和NRDE2i这两个检出率低于50%的扰动,假阴性细胞的扰动签名同样显著更低——"没被检出"很可能等于"没被扰动",而非算法漏检。
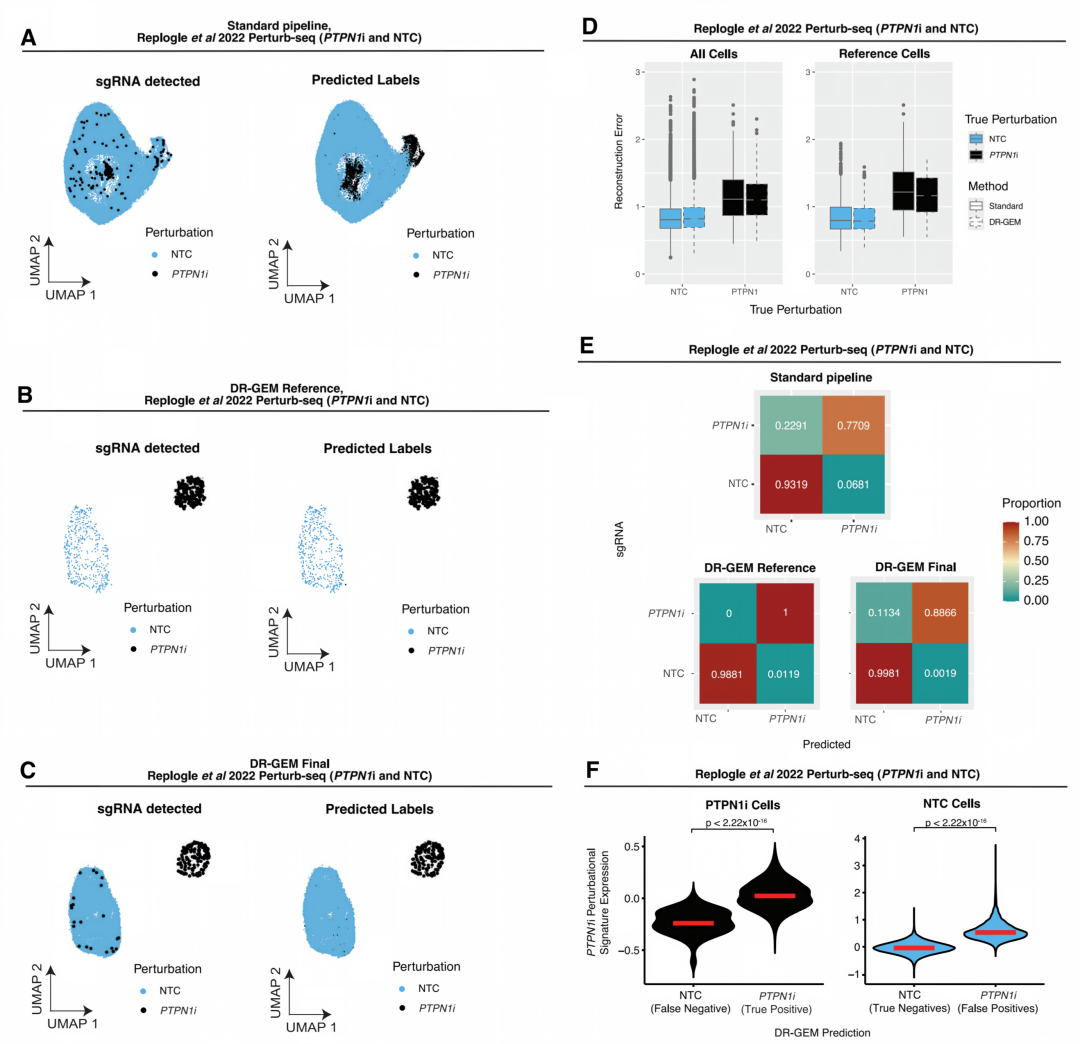
▲ 图9|DR-GEM捕捉Perturb-seq中PTPN1 CRISPRi的转录影响。A-C对比标准流程、DR-GEM高置信参考与全体细胞的嵌入;D-E展示RE收紧与分类性能;F展示签名表达与预测结果的双向验证。
▲ 图10|DR-GEM在极端类别不平衡下捕捉基因扰动状态。A-E为MED19i、SRRTi、MRPL24i、CASP8AP2i、NRDE2i五种扰动的嵌入与预测;F-G量化预测准确率并以扰动签名验证假阴性的生物学含义。
横向对比、局限与开泰视角
最后是硬碰硬的对决:与三个专门的稀有细胞检测框架GiniClust3、scCAD、CIARA在9个数据集、14项稀有细胞检测任务上对垒(覆盖模拟、空间转录组、Perturb-seq、scRNA-seq),DR-GEM在11/14项任务上胜出。GiniClust3在囊性纤维化数据上颗粒无收;CIARA在全部6个Perturb-seq子集及MERFISH、HNSCC上均未检出稀有细胞;scCAD则 missed 全部Perturb-seq子集与HGSC空间数据。当然也要公平地讲:PBMC数据上scCAD最优,胸腺发育数据上CIARA最优——每个方法都有主场。
冷静看局限:Phase II的多轮平衡子采样带来更高的计算开销(作者证明较少轮次即可收敛,并建议引入在线学习动态更新);与所有降维方法一样,推荐嵌套使用(先分大群,再逐群细分);Phase IV依赖签名质量,签名选得不好注释跟着跑偏。
这篇文章对我们的三个日常场景都有直接价值。其一,做DIA蛋白质组或单细胞数据分析时,如果某个亚群在PCA/UMAP上总是一团糊,先别急着怪数据——算一下RE右尾富集了谁,很可能就是被"多数派暴政"埋没的稀有群体。其二,DR-GEM的置信分数机制值得借鉴到任何流程里:给每个预测一个诚实的不确定性,比把准确率吹到天花更有用。其三,它的思想是平台无关的——空间组学、Perturb-seq、甚至人群-scale的祖先可视化偏差矫正,都可以套用"从错误中学习"这层元框架。R包已开源,值得在自己最头疼的那个数据集上跑一轮试试。
稀有不是噪声,少数不代表不重要。当模型学会向自己的错误低头,被淹没的信号才会浮出水面。
参考资料:Yeh CY, Sun MW, Zhu D, Jerby L. DR-GEM enables self-supervised machine learning for single-cell embeddings and annotations. Nature Communications (2026). doi: 10.1038/s41467-026-77908-z