
 English
MSCP:整合27个癌症蛋白质组数据源,为15,964个蛋白建立质谱证据地图
一句话看懂:癌症蛋白质组的质谱证据散落在几十个研究、不同数据库版本、不同采集模式之中,研究者想拼出一份"癌症里到底被质谱看到过哪些蛋白"的清单,往往得手动对表、逐一核对。美国约翰斯·霍普金斯大学与 Frederick 国家癌症研究实验室团队构建了 MSCP(Mass Spectrometric Detected Cancer Proteins,质谱检测癌症蛋白)资源:把 27 个大规模癌症蛋白质组数据源——涵盖人类肿瘤队列、癌细胞系与患者来源异种移植(PDX)模型——统一映射到 UniProtKB-Swiss-Prot(2025_01 版),整合出一份 15,964 个质谱支持的人蛋白统一目录。以 neXtProt PE1 为基准,新增 525 个此前缺少质谱证据的蛋白,其中 37 个是曾因基因组定位不一致而被标注为"染色体假(chromosome-false)"的条目;这些新蛋白约 85% 定位于膜、细胞核或细胞外区域,功能上富集于免疫/黏膜屏障与染色质—基因组调控通路;研究还用合成特征肽做正交验证,把代表蛋白稳稳钉在 MS1 前体离子与 MS2 碎片离子两个层面上。
一、痛点:癌症蛋白质组的"证据孤岛"
先看一个很现实的问题。蛋白质组学早已进入高通量质谱时代,数据库也不少:UniProt 知识库(UniProtKB)负责全面的蛋白注释,PRIDE/ProteomeXchange 做数据归档,PeptideAtlas、MassIVE-KB 支持大规模整合与定量,neXtProt 则专门整理人类蛋白的存在性(protein existence, PE)证据。
但作者指出,"质谱确证过的癌症蛋白"这类证据,依然零散地分布在各个独立研究与仓库里——缺乏统一的标识符、统一的队列来源(provenance)、也没有"以癌症为中心"的聚合视图。后果很直接:做癌症蛋白质组学、蛋白基因组学或生物标志物发现的研究者,常常要手动跨队列、跨采集模式、跨数据库版本去拼装与核对质谱证据蛋白清单。这份"拼桌子"的工作既费时,又容易因版本漂移(version drift)而出错。
MSCP 的目标正是补上这一环:把大规模癌症队列与模型系统的质谱确证证据,整合成一份统一、可溯源、与 UniProtKB 对齐的资源,从而支持标准化的比较、队列/模型层面的子集查询,以及面向覆盖度的证据聚合。
二、MSCP 怎么建:27 个数据源 + 统一到 UniProtKB 坐标
MSCP 的数据来源,是从公开癌症蛋白质组资源中收集的高置信度鉴定结果(已处理的肽段/蛋白鉴定表),来自美国国家癌症研究所蛋白质组数据共享平台(PDC)与 ProteomeXchange/PRIDE 仓库,共 27 个数据源,覆盖三类样本:
- 癌细胞系:包括 A549、NCI-H226、T47D、CCRF-CEM、RPMI-8226、COLO205、NCI-H23 等细胞系的独立蛋白质组数据集,以及一个 7 株细胞的混合蛋白质组数据集; - 肿瘤组织:来自 CPTAC 多个癌种队列(肺鳞癌、胶质母细胞瘤、卵巢癌、胰腺导管腺癌等)以及胰腺组织的空间蛋白质组数据集; - PDX 模型:PDX 组织、细胞与 CompRef 全局蛋白质组数据集。
为了保证跨来源可比、把版本漂移压到最小,所有蛋白标识符都被统一映射到 UniProtKB-Swiss-Prot 人类参考蛋白质组(2025_01 版);跨研究存在的不同推断流程带来的冗余,则通过"以基因为中心的 UniProt 条目框架"来化解——不同研究报出的蛋白变体/异构体,在合适时归并到对应的 UniProtKB 条目之下。
整合采用并集(union)策略:只要某个 UniProtKB 条目在至少一个来源中满足鉴定标准,就被纳入。鉴定标准很明确——肽段-谱图匹配(PSM)与肽段/蛋白鉴定控制在 ≤1% FDR,即沿用各原始数据集的质量控制流程。一个值得注意的细节是,作者刻意区分了两个概念:
"鉴定蛋白(identified protein)":在 MSCP 中被定义为受来源高置信度鉴定输出支持的 UniProtKB-Swiss-Prot 条目——这是 MSCP 的口径; "定量蛋白(quantified protein)":某些研究在鉴定置信度之外还叠加了额外过滤(样本间定量完整性、最小非缺失率、队列特定报告阈值等),因此同一队列的"头条数字"可能不同。
更重要的是,MSCP 在蛋白条目层面保留了数据集级别的溯源信息:每个蛋白都标注了它由哪些来源支持、以及各自的采集模式(DDA/DIA),因此用户既可以看整合全貌,也能随时切出"某个队列/模型/采集模式"的子集。
▲ 图1|MSCP 构建与癌症模型覆盖总览。整合基于质谱鉴定(MS identification)的三类癌症相关样本——癌细胞系、肿瘤组织、PDX 模型,最终得到一份映射到 UniProtKB 的 15,964 个人蛋白统一目录;图中同时标出各类样本贡献的鉴定蛋白数,凸显 MSCP 作为"多来源、癌症语境"蛋白证据资源的定位。
三、构建结果:三类样本合出 15,964 个蛋白
整合后的账目很清楚:
- 癌细胞系(NCI-7 等,8 个数据来源):11,116 个蛋白; - 肿瘤组织(CPTAC 队列等,13 个数据来源):15,442 个蛋白; - PDX 与 CompRef(6 个数据来源):14,200 个蛋白。
三类样本互补,总共整合出 15,964 个蛋白——这就是 MSCP 当前版本的核心目录。研究强调,正是"多样数据集的均衡整合 + 严格质控"这两点的结合,才保证了数据库的稳健与可靠。
从单个数据源的贡献看,多个来源本身就相当可观:前瞻性乳腺癌蛋白质组(BRCA-C)约 12,424 个蛋白、PDX 蛋白质组约 12,041 个、胰腺导管腺癌(PDAC-D)约 11,513 个,都超过了 11,000 个。图 2A 用条形图逐一展示了 27 个数据源的鉴定蛋白数。
而累积整合的趋势更关键:随着数据源逐个加入,MSCP 的蛋白总数稳步爬升(图 2B,黄色柱为累积蛋白总数)。原因在于——每个新增的癌症队列/模型,既贡献一大块"高度重叠的核心蛋白",又贡献一小撮持续存在、却又落在 neXtProt PE1 之外的蛋白;后者正是靠异质样本类型与互补采集策略(DDA/DIA)才能被"捞"出来的。作者特别提醒:累积曲线的"平滑感"会受数据源排序影响,因此他们额外给出了逐来源的增量值(Supporting Table S2),让每个数据源的贡献可以独立于绘图顺序来解读。
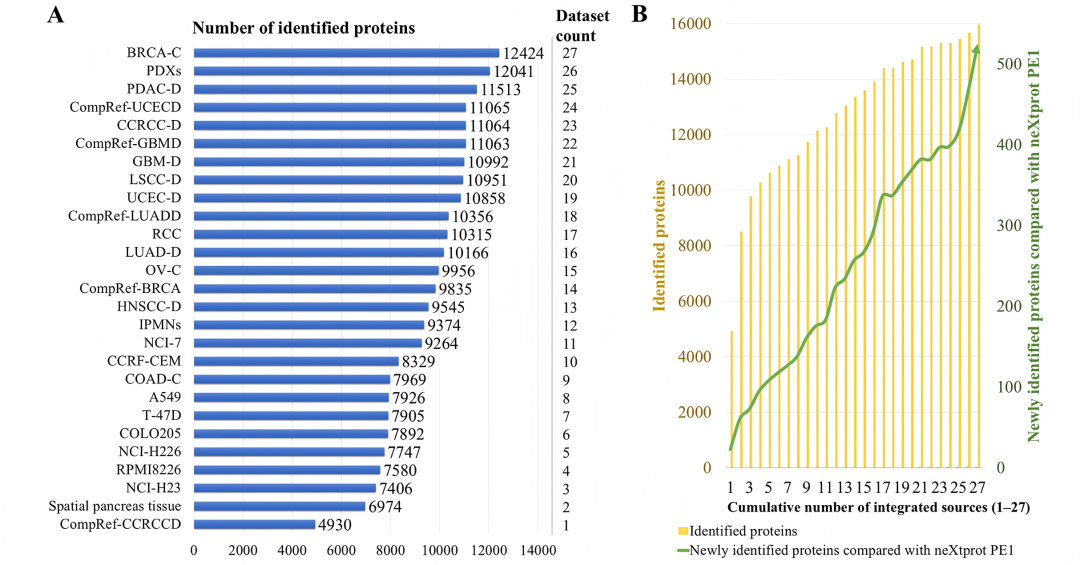
▲ 图2|各数据源的蛋白鉴定与累积整合。(A)MSCP 中 27 个数据源各自鉴定到的蛋白数量;(B)数据源逐个加入后的累积并集——黄色柱为整合目录中的累积蛋白总数,绿色折线为每个来源相对 neXtProt PE1 新增的蛋白数(x 轴为累积整合的数据源数,1–27)。
四、对照 neXtProt PE1:新增 525 个质谱证据蛋白
要衡量"整合到底多带来了什么",需要一把标尺。UniProtKB 用蛋白存在性(PE, protein existence)来分级,从证据强度由高到低分为 5 类:
- PE1:有质谱或非质谱方法的蛋白级证据; - PE2:有转录本表达证据; - PE3:与其他物种同源推断; - PE4:来自基因模型预测; - PE5:基因不确定,或为重复序列。
在 neXtProt 最终版本(2023-09)中,人类蛋白质组共有 20,389 个条目,带有不同的存在性证据等级。
MSCP 把整合目录与 neXtProt PE1 基准逐一比对,得到核心增量:525 个蛋白新增了质谱证据(相对于 neXtProt PE1)。这个数字不只是一个"覆盖率"指标——它意味着这 525 个蛋白此前缺少实验层面的蛋白级证据,如今在癌症语境的多来源整合中,被质谱实打实地"看到"了。
作者进一步把 PE 状态与染色体分布关联起来,做"存在性"的深挖。这里有几个值得记住的发现:
- 各种蛋白质组数据集的贡献让新鉴定蛋白稳定增长,同时也说明整合同时用上了 DDA 与 DIA 两种采集模式的价值; - 525 个新蛋白里,37 个是先前被标注为"染色体假(chromosome-false)"的条目——这类基因条目因基因组定位不正确、或证据不一致而被重新指派或移除; - 从亚细胞定位看,这 525 个新蛋白有 85% 落在膜(44.5%)、细胞核(20.5%)或细胞外区域(20%)(另有细胞质 10%、内质网 2.5%、高尔基体 2.5%)——恰好属于"难检测"的蛋白类别。
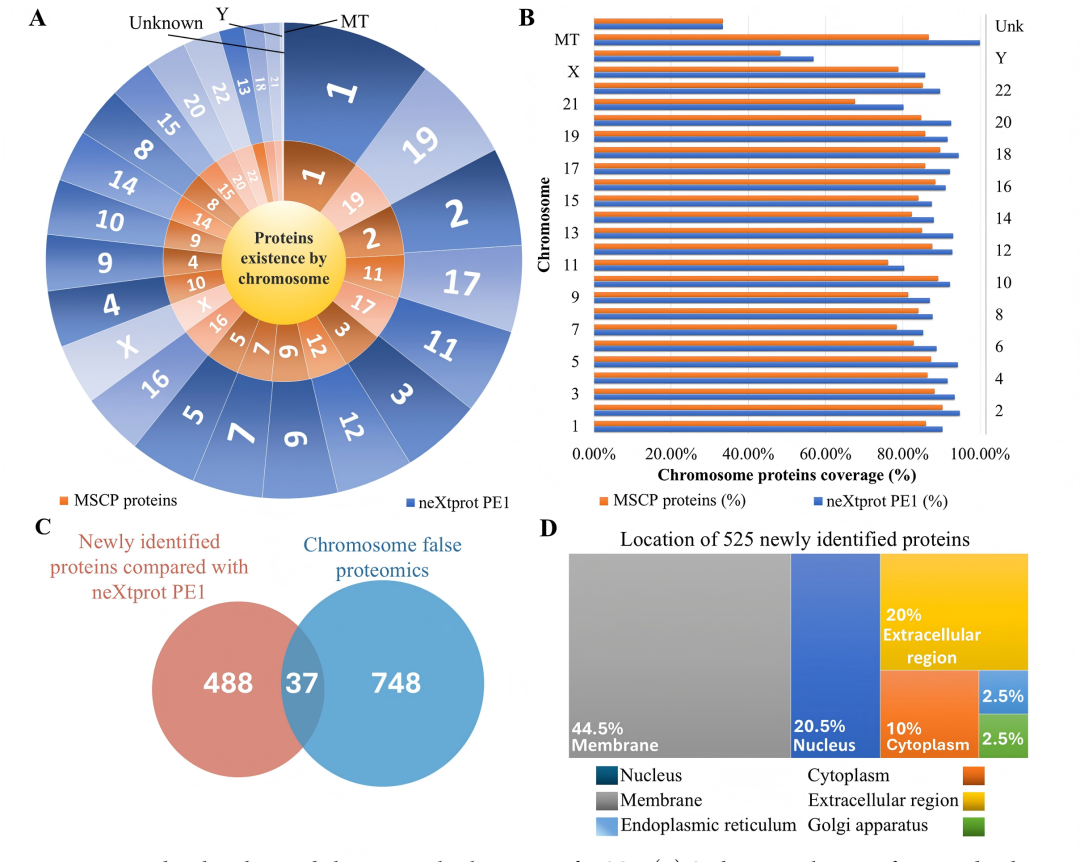
▲ 图3|MSCP 的蛋白存在性基准与染色体级覆盖。(A)MSCP 与 neXtProt PE1 参考集蛋白在人类染色体上分布的旭日图(sunburst);(B)逐染色体比较 MSCP 与 neXtProt PE1 的检出蛋白数,突出染色体级覆盖与 MSCP 整合所弥补的缺口;(C)525 个新鉴定 MSCP 蛋白与先前"染色体假"条目的重叠(488 / 37 / 748),说明此前注释不一致的蛋白被"捞回";(D)新鉴定蛋白按细胞组分(cellular component)的树图分布,凸显膜相关、核与细胞外等难检测类别的富集。
五、DDA 还是 DIA?谁在贡献"新蛋白"
既然整合同时纳入了两种采集模式,一个自然的问题是:新蛋白到底更多来自 DDA 还是 DIA?
把 525 个新蛋白按采集模式归类,答案有点出人意料:
- DIA 贡献 333 个; - DDA 贡献 300 个; - 两者有重叠,总数去重后为 525 个。
也就是说,DIA 采集模式贡献的新鉴定蛋白比 DDA 更多。图 4A 用热图展示了 525 个新蛋白中 51 个的代表性分布——它们在至少 9 个不同数据源、跨两种采集模式下被共享鉴定,直观体现了 DDA 与 DIA 的互补性。
研究还把新蛋白与 GENCODE 蛋白编码基因列表(GENCODEv46)做了比对。人类蛋白质组计划(HPP)一直在把 UniProtKB 的蛋白清单与 GENCODE 数据库对齐,因此作者特别关注"在 GENCODE 蛋白编码基因列表里找不到"的新蛋白:
- MSCP 中这类蛋白共 110 个; - 其中 DIA 贡献 91 个、DDA 贡献 39 个。
这 110 个蛋白对应的,是 Ensemble-GENCODE "未找到"列表里的蛋白编码基因(1254 个 UniProtKB-Swiss-Prot 条目)。KEGG 通路富集(图 4D)则提示,膜相关蛋白(尤其神经活性配体—受体相互作用通路)是富集的重点——这与染色体层面的结论相互印证:MSCP 强化了此前难以检测的蛋白类别(如膜蛋白)的质谱检出。
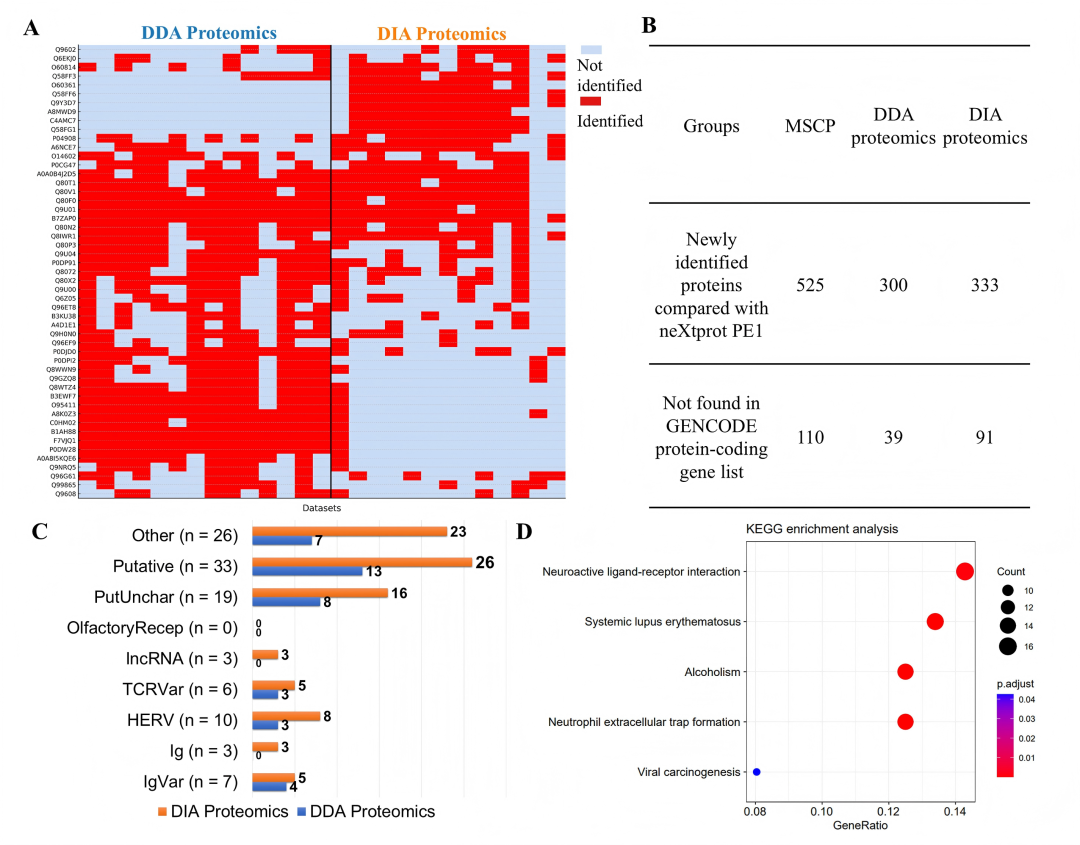
▲ 图4|新鉴定蛋白的特征刻画与采集模式贡献。(A)代表性新蛋白在来源间的检出热图,按采集模式(DDA vs DIA)分层,展示跨研究重复性;(B)按采集模式汇总新鉴定蛋白,体现 DDA 与 DIA 的相对贡献;(C)相对 Ensembl/GENCODE 蛋白编码基因列表(GENCODEv46)对新蛋白分类,含列表之外蛋白及其在两模式中的分布;(D)新鉴定蛋白的 KEGG 通路富集,突出膜相关功能主题。
六、从组织到网络:这些新蛋白"住在哪、和谁在一起"
数据库的第二个落脚点是生物学语境。研究把新蛋白与人类蛋白图谱(The Human Protein Atlas, HPA)的器官/组织蛋白质组做了对照,看哪些器官从 MSCP 的增量覆盖中受益最多(图 5A):