
 English
多祖源转录组关联研究:为乳腺癌风险锁定290个候选易感基因
一句话看懂:一项覆盖非洲、亚洲、欧洲三大祖源的转录组关联研究(TWAS),先用 652 份正常乳腺组织构建"基因调控预测模型",再把它套用到 178,534 例乳腺癌 + 248,300 例对照的 GWAS 数据上,一举锁定 290 个与乳腺癌风险显著相关的基因——其中 103 个是既往 TWAS 从未报道的、46 个甚至远离所有已知 GWAS 风险位点。更关键的是,它跳出"只看表达量"的旧框架,把 可变剪接(AS)与 3′UTR 可变多聚腺苷酸化(APA)一并纳入,并用 CRISPR 敲除、siRNA 敲低、单细胞测序,为 169 个基因补上了功能证据。
核心数字速览
- 建模组织样本:652 份正常女性乳腺组织(Komen 381 + ABCC 156 + GTEx 115) - 关联分析样本:178,534 例乳腺癌 + 248,300 例对照,跨非洲/亚洲/欧洲三大祖源 - 预测模型规模:表达 21,195 个、剪接 70,541 个(覆盖 13,161 基因)、APA 14,730 个(覆盖 9,499 基因) - 关键产出:290 个风险相关基因(103 个全新、46 个远离已知 GWAS 位点),169 个获功能证据
一、GWAS 找到了"地址",却一直找不到"住户"
乳腺癌是全球女性最常见的癌症,遗传因素在其病因中扮演重要角色。过去二十年,全基因组关联研究(GWAS)已经找到 200 多个与乳腺癌风险相关的遗传位点。但一个尴尬的事实是:这些位点加起来只能解释约 18% 的家族性相对风险,而且绝大多数落在非编码区。
非编码区不编码蛋白,它更像一个个"调控开关"。GWAS 告诉我们"哪个开关可能坏了",却回答不了最关键的临床问题——这个开关到底控制着哪个基因?
转录组关联研究(TWAS)正是为解决这个问题而生:它把基因型—表达量的调控关系与 GWAS 的疾病关联缝合起来,直接评估"基因的调控水平"与"疾病风险"之间的关系,从而把位点翻译成基因。
但既往的乳腺癌 TWAS 有两个明显短板:
模型"借错了组织"
。由于正常乳腺组织的转录组数据稀缺,过去几乎所有的乳腺癌 TWAS 建模时用的都是其他组织的数据。对"只在乳腺里表达"的基因而言,这种模型的生物相关性非常可疑。 人群过于单一
。除少数研究外,绝大多数乳腺癌 TWAS 只在欧洲祖源女性中开展,其他人种的遗传结构差异被忽略,而祖源差异恰恰可能藏着只在特定人群可见的信号。
这项发表在 Nature Communications 的研究,正是冲着这两个痛点来的。
二、研究设计:把"正常乳腺组织"打磨成一把精准的尺子
研究的第一步,是亲手造尺子——构建祖源特异性的基因调控预测模型。
建模用的转录组数据来自三个来源,合计 652 份正常女性乳腺组织:
- Susan G. Komen 正常组织库(Komen):381 份 - 亚洲乳腺癌联盟(ABCC):156 份 - GTEx 计划:115 份
按祖源拆开看,参与建模的女性包括 150 名非洲祖源、205 名亚洲祖源、297 名欧洲祖源。研究团队对每个祖源分别建模,尽可能贴合各自不同的遗传结构与连锁不平衡模式——这正是既往研究常常忽略的环节。
同时,它不只预测 基因表达,还预测另外两类被长期忽视的转录后事件:
- 可变剪接(alternative splicing, AS):同一个基因,剪成不同的 mRNA 亚型; - 3′ 端可变多聚腺苷酸化(APA):同一条 mRNA 在不同位置"截尾",影响其稳定性与翻译效率。
对应地,研究构建了三套"体检"体系:Exp-TWAS(表达)、spTWAS(剪接)、APA-WAS(APA)。
方法上,团队组合了三种建模策略:对乳腺组织数据用 弹性网络回归(elastic net, α=0.5);借助 JTI 方法跨组织借力 GTEx 的 33 种组织数据;再用改良的 UTMOST 框架把同祖源、不同来源的数据(例如欧洲的 Komen + GTEx)融合建模。
模型质量如何?研究者做了交叉验证:在 8,926 个预测 R² ≥ 0.01 的基因上,用一套数据去"预测"另一套数据的表达量,相关系数高达 0.87——说明这把"尺子"是可信的。
最终纳入下游分析的模型规模是:
- 21,195 个基因表达预测模型; - 70,541 个剪接事件模型,覆盖 13,161 个基因; - 14,730 个APA 事件模型,覆盖 9,499 个基因。
研究的另一端,是大样本 GWAS 数据,合计 178,534 例乳腺癌与 248,300 例对照:
- 非洲祖源:18,034 例 / 22,104 例(AABCG 联盟) - 亚洲祖源:27,116 例 / 112,407 例(ABCC + BCAC) - 欧洲祖源:133,384 例 / 113,789 例(BCAC)
模型与 GWAS 对接,用 S-PrediXcan 做关联分析,再以逆方差加权做跨祖源荟萃分析,从而既看"三大人群的合并信号",也看"各个祖源的独有信号"。
三、核心结果①:290 个候选易感基因浮出水面
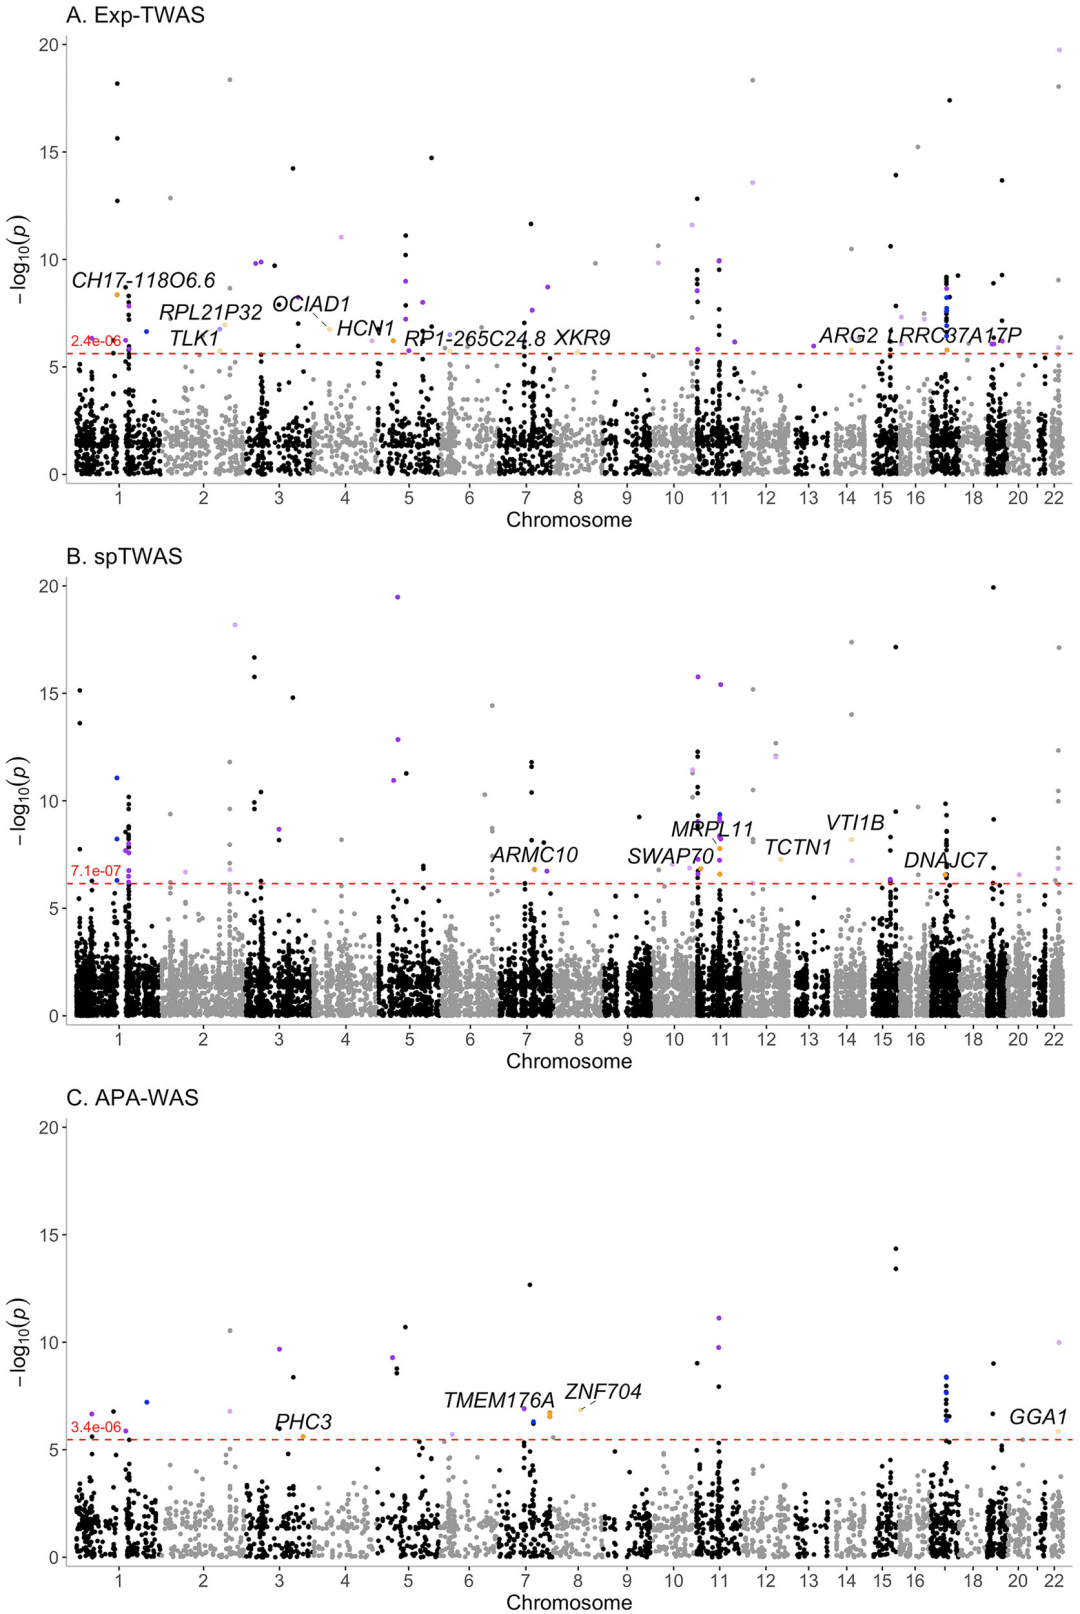
▲ 图1|乳腺癌风险的"曼哈顿全景"。A. Exp-TWAS(表达类,显著阈值 2.4×10⁻⁶);B. spTWAS(剪接类,7.1×10⁻⁷);C. APA-WAS(可变多聚腺苷酸化类,3.4×10⁻⁶)。每个点代表一个被检验的基因/剪接事件/APA 事件,按基因组位置和关联 P 值排布,水平虚线为 Bonferroni 校正后的显著性阈值。橙色标注点及其基因名代表"既往 TWAS 未报道、且不在任何既往 GWAS 位点"的新发现;紫色点代表既往 TWAS 未报道的基因;蓝色点代表距既往 GWAS 位点至少 500 kb 的基因。
在整体乳腺癌风险(overall)层面,研究首先在三类事件中各自跑出了显著信号:
- 表达(Exp-TWAS):68 个基因达到 Bonferroni 阈值 2.4×10⁻⁶; - 剪接(spTWAS):44 个基因中的 56 个剪接事件显著(阈值 7.1×10⁻⁷); - APA(APA-WAS):21 个基因中的 22 个 APA 事件显著(阈值 3.4×10⁻⁶)。
在祖源分层分析中,又额外捞出:80 个基因(表达)、87 个基因中的 114 个剪接事件、30 个基因中的 34 个 APA 事件。
把三类事件合并、去重后,共得到 263 个与整体乳腺癌风险显著相关的基因,分布在 87 个独立位点上;若再加上按雌激素受体(ER)状态分层找到的 14 个 ER 阳性相关基因与 13 个 ER 阴性相关基因,总计 290 个基因。
其中最引人注目的是两个"新鲜度"指标:
- 103 个基因是既往任何 TWAS 都未报道过的; - 46 个基因距既往 GWAS 识别的风险位点至少 500 kb——它们可能代表全新的风险区域。
此外,在按 ER 状态分析的 192 个显著基因中,39 个基因在 ER 阳性与 ER 阴性乳腺癌中的关联存在显著差异(其中 26 个只在 ER 阳性中显著,11 个只在 ER 阴性中显著)。这提示:一部分遗传风险,是"分亚型"的。
四、核心结果②:不止"表达量"——剪接与 APA 贡献了 115 个独有基因
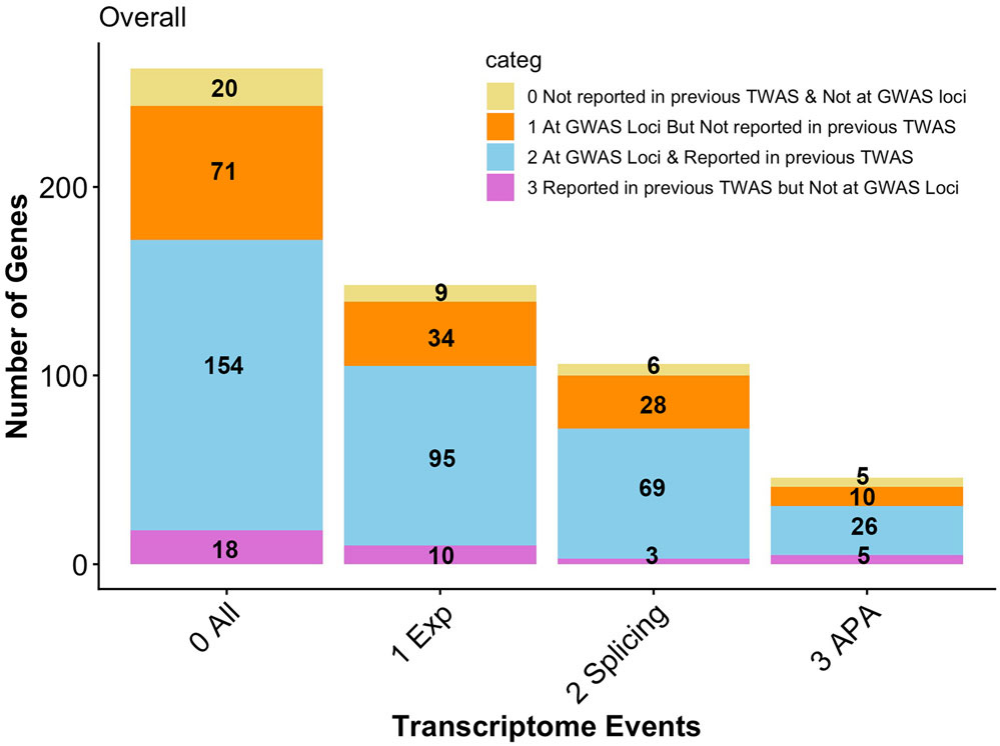
▲ 图2|按转录事件类型统计的乳腺癌风险关联基因。柱状图汇总三类分析在 Bonferroni 阈值下发现的整体乳腺癌风险关联基因数量,并按两种维度四分类堆叠着色:黄色=既往 TWAS 未报道且不在 GWAS 位点;橙色=位于 GWAS 位点但既往 TWAS 未报道;蓝色=位于 GWAS 位点且既往 TWAS 已报道;紫色=既往 TWAS 报道但不在 GWAS 位点。263 个基因按事件类型拆为:表达 148、剪接 106、APA 46(同一基因可被多种事件识别)。
从图2看,263 个基因按事件类型拆解为:表达 148 个、剪接 106 个、APA 46 个(同一基因可被多种事件识别)。三个数字相加远超 263,恰恰说明——
很多基因,只有跳出"表达量"才能被看见。
数据印证了这一点:有 115 个显著基因仅由 spTWAS 或 APA-WAS 发现,其中 17 个既是既往 TWAS 未报道、又不在任何已知 GWAS 位点。这些基因通过转录后调控影响乳腺癌风险,而传统的 Exp-TWAS 根本无法捕捉。
论文给出了一个有临床意义的例子:RAD51B。这个基因早已被认为与乳腺癌风险有关,却一直没被纳入乳腺癌基因检测。本研究通过 spTWAS 独立识别出它——为正式把它列为乳腺癌易感基因、纳入未来的基因检测,提供了新的证据。
五、多祖源的价值:46 个基因在三大人群中"同时亮灯"
把三大人群的数据并排比较,最有说服力的结果是:
- 46 个基因在全部三个祖源中都显示与乳腺癌风险相关; - 70 个基因在两个祖源中显著,其中不乏"远离所有已知 GWAS 位点"的新基因。
为什么这一点重要?因为不同祖源的遗传结构不同、用来预测转录事件的变异集合也不同。一组基因如果能在三种独立的人群中都"亮灯",它更可能是真正的因果基因,而不是统计假象。
细定位(fine-mapping,用 FOCUS 工具)给出了一个漂亮的佐证:在 2q33.1 位点,CASP8 在三个祖源中都被优先选出——这个早已确立的乳腺癌基因,再次被强化。
反过来,研究也发现了祖源特异性信号,例如 1q22 位点上的若干基因只在欧洲祖源中被识别。研究者谨慎地指出:这既可能是真实的祖源特异性效应,也可能只是非欧洲样本量偏小造成的效能不足——这恰恰说明,把非欧洲人群做大做全,是未来研究的关键方向。
六、功能验证:从"统计关联"到"功能必需"的三重证据
一个 TWAS 找到的基因,可能只是"统计上相关"。要把它坐实为易感基因,必须上功能实验。这项研究为 169 个基因提供了额外的功能证据,靠的是三把"锤子":
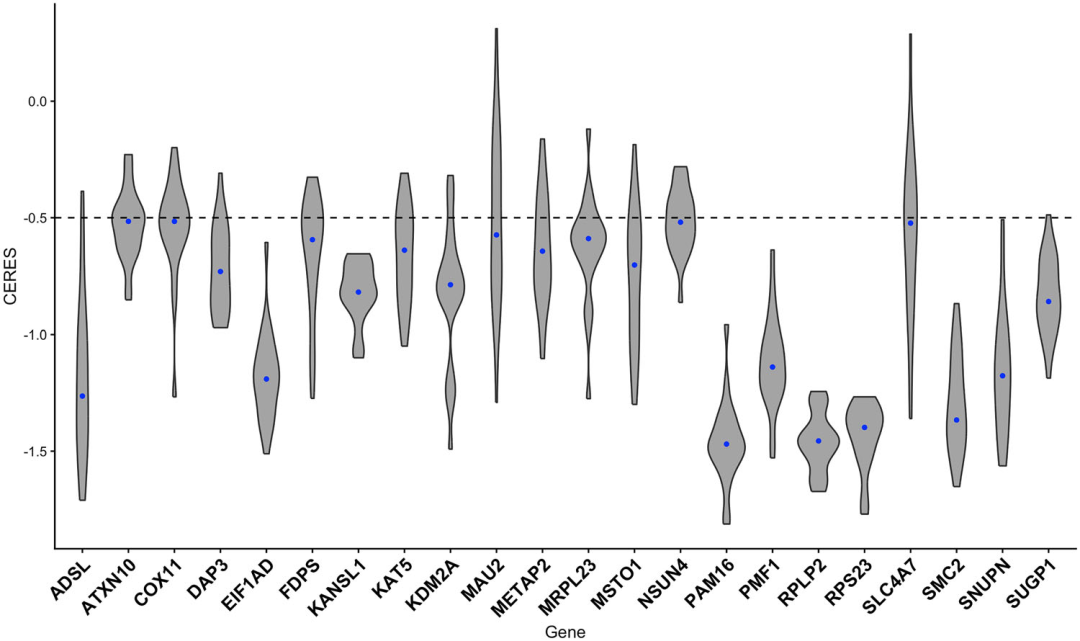
▲ 图3|22 个候选基因对乳腺癌细胞增殖的"必需性"(CERES 评分)。小提琴图展示 CRISPR-Cas9 全基因组敲除筛选中,22 个基因在 44 个侵袭性乳腺癌细胞系里的 CERES 评分分布。CERES 越低,说明基因被敲除后细胞耗竭越明显、对细胞越"必需";虚线为 ≤−0.5 的判定阈值。
第一锤:CRISPR-Cas9 敲除必需性。 在 216 个蛋白编码基因中,203 个有 CERES 数据(覆盖 44 个侵袭性乳腺癌细胞系)。其中 22 个基因的中位 CERES 评分 ≤ −0.5,意味着敲掉它们会显著抑制乳腺癌细胞增殖——它们是癌细胞"活命所需"的基因。
第二锤:siRNA 敲低。 团队在三种不同亚型的乳腺癌细胞系(MCF-7 / ER+、SK-BR-3 / HER2+、MDA-MB-231 / 三阴性)中做了 siRNA 敲低实验,216 个基因里有 93 个在敲低后细胞增殖显著下降(P < 0.05)。
第三锤:单细胞"定位"。 用 GTEx 正常乳腺组织的单细胞 RNA 测序数据,研究者比较了上皮细胞与其他细胞类型:203 个基因中有 130 个在上皮细胞中差异表达——而上皮细胞正是乳腺癌的细胞起源。其中包括 8 个既往 TWAS 未报道、又远离 GWAS 位点的新基因。
这三层证据叠加起来,让"候选基因"离"因果基因"更近了一步。
七、生物学信号:这些基因落在哪些通路上?
把 290 个基因中的 216 个蛋白编码基因拿去做 KEGG 通路富集,结果与乳腺癌的经典认知高度吻合:
- p53 信号通路、同源重组修复、雌激素信号通路、细胞凋亡、PI3K-Akt 信号通路——这些都是乳腺癌发生发展中公认的核心通路(其证据多来自对肿瘤组织体细胞突变的分析); - 此外还提示了内分泌耐药、磷脂酶 D 信号、Rap1 信号等通路。
由此可以得出一个耐人寻味的推论:驱动肿瘤发生的基因,可能同时也在影响个体"是否易感"乳腺癌。
在细胞层面,研究还发现与 ER 阳性乳腺癌风险相关的若干基因(如 NSUN4、PEX14、THBS3)在管腔上皮细胞中显著富集——而 ER 阳性乳腺癌正是起源于管腔上皮。这为"亚型特异性风险基因"与其"细胞起源"之间架起了直接桥梁。
八、几个"值得记住"的候选基因
在 103 个全新基因中,有几位是"熟面孔、新身份":
- MRPL11:线粒体核糖体大亚基的关键蛋白,在肿瘤中频繁改变,其高表达与 IV 期神经母细胞瘤的不良预后相关; - HCN1:此前已被报道与乳腺癌不良生存显著相关; - TLK1(Tousled 样激酶 1):参与细胞迁移与转移,抑制它能让乳腺癌细胞(MDA-MB-231、4T1)对多柔比星更敏感; - PHC3:被报道为包括乳腺癌在内的上皮肿瘤的潜在治疗靶点; - RAD51B:由 spTWAS 识别,支持其正式进入乳腺癌基因检测清单(见第四节)。
九、这项研究意味着什么?
一份更完整的乳腺癌易感基因清单
:290 个基因,其中 103 个全新、46 个脱离已知 GWAS 位点,实质性地扩展了乳腺癌遗传风险的"候选名单"。 GWAS 位点终于有了"靶基因翻译"
:通过条件分析,189 个基因可能正是 76 个既往 GWAS 风险位点背后的靶基因;换言之,这项研究为"GWAS 找到的地址"配上了不少"住户姓名"。 方法学范式的升级
:多祖源 × 三类转录事件 × 功能验证的组合,比"单一人群 + 只看表达量"的老套路,能挖出更多、也更可信的信号。 为后续机制研究提供抓手
:CRISPR 必需性、siRNA 敲低、单细胞定位三层证据,为这些基因的机制研究排出了优先次序。
研究的局限(作者自述)
- 非洲与亚洲祖源的关联分析样本量仍偏小,可能漏检祖源特异性信号,也可能因效能不足而出现"假阴性"; - 严格的 Bonferroni 校正(对高度相关的转录事件)可能偏保守,会损失一部分真阳性; - 条件分析仅调整了"最近的单个 GWAS 变异",对存在多个独立因果变异的位点考虑不足; - 预测模型仅使用顺式(cis)SNP,尚未纳入反式(trans)eQTL——后者仍是建模的难题。
十、方法学启示:为什么"多祖源 + 多事件 + 功能验证"值得借鉴
对做队列与多组学研究的同行来说,这项研究的价值不止在结论,更在打法的示范:
- 把"组织对、人群全"作为建模前提——用正常乳腺组织、按祖源分组建模,从源头提高预测模型的生物相关性; - 把转录后调控拉进视野——剪接与 APA 让 115 个基因"只此一路可见",说明"只看表达量"会系统性漏检; - 把统计关联与功能实验绑在一起——CRISPR / siRNA / 单细胞三层验证,让"候选基因"更接近"因果基因"。
十一、写在最后
从"GWAS 地址"到"TWAS 基因",我们正在把乳腺癌的遗传风险图,从粗粒度的路标逐步补全为带门牌号的详细地图。这项研究提醒我们两件事:一是"人群的多样性"本身就是发现力——有些信号只在特定祖源中现身;二是"表达的多样性"同样重要——同一个基因,剪接方式不同、尾部长度不同,风险也可能不同。
当"谁易感"这个问题被回答得越来越细,乳腺癌的风险分层、早期筛查与精准预防,才有可能真正落地。
参考文献:Ping J, Jia G, Cai Q, et al. Multi-ancestry transcriptome-wide association studies uncover insights into breast cancer genetics and biology. Nature Communications, 2026, 17:7025. DOI: 10.1038/s41467-026-73801-x