
 English
把空间转录组里"串门"的分子请回去
核心结论:空间转录组(ST)测到的每个细胞的"基因表达",其实是三份信号的混合——它自己的真表达、从邻居细胞扩散进来的分子、外加一份非特异背景。张冠李戴的分子会产生大量"假共表达",让你把神经元基因"看到"微胶质细胞头上。2026 年 10 月 Nature Methods 刊出的 resolVI 用一个变分自编码器(VAE)把这笔"混账"逐细胞拆开、校正:在 6 种分割算法、6 类 ST 平台的数据上,假共表达被显著清除、真共表达被保留;顺带还挖出了肝癌免疫微环境的空间分区,以及 DSS 结肠炎"肉眼愈合"后仍残留的屏障缺陷。模型开源并入 scvi-tools,一块 RTX 3090 就能跑 140 万细胞。
一句话看懂:resolVI 不重新分割细胞,而是在任何分割算法后面加一步"算账"——把每个细胞的分子拆成"自己的 + 邻居的 + 背景的"三份,再把账算平。
一、空间转录组为什么"会说谎"
单细胞分辨率的空间转录组分两大路线:成像式(10x Xenium、Vizgen MERSCOPE、Nanostring CosMx、MERFISH)逐个定位荧光标记的 RNA 分子;测序式(Stereo-seq、Visium HD)对空间条码化的 RNA 做高通量测序。无论哪条路线,要得到"每个细胞表达了哪些基因",都必须先做分割(segmentation):把组织平面切成一个个近似细胞的区域,再把区域内的分子数到该细胞的账上。
问题就出在"数账"这一步。论文把误差来源归为三类:
- 分割不准:细胞密度高、染色信号弱、形状不规则,都会让算法画错边界。细胞在垂直于切片的方向上彼此重叠,更是成像式技术的天然盲区; - 扩散(diffusion):RNA 分子因组织处理、三维重叠等原因"串"到相邻细胞里,尤其是紧挨着的邻居细胞; - 背景(background):每个切片都有一份非特异的、不属于任何细胞的背景信号。
这三类误差的后果在下游非常刺眼:本该互斥表达的基因对出现了"假双阳性"——微胶质细胞"表达"了兴奋性神经元的标志基因,成纤维细胞"表达"了髓系细胞的标志。已有的表达感知分割工具(Baysor、ProSeg)确实能改善分割,但论文实测表明,残余的错配依然大量存在,它把很多应用卡在"只能验证已知细胞亚群"的水平,而难以发现新的细胞状态。
二、resolVI 的思路:不重新画格子,而是把账拆开
resolVI 的定位很聪明:它不做分割,而是站在任何分割算法的下游,输入就是"已经分好细胞的表达矩阵 + 空间坐标 + 切片编号",输出是校正后的低维表征和校正后的表达谱。
模型用变分自编码器实现,核心假设写成一行公式:
- 观察到的表达 = α0 × 自身真表达 + α1 × 邻居真表达的加权和(扩散)+ α2 × 背景表达
三个组分各用不同的统计分布建模:真表达与扩散服从负二项分布(允许过离散),背景服从泊松分布(无非特异过离散)。每个细胞都有一组专属的 α 系数,由一个"扩散编码器"网络估计——也就是说,哪些分子是错的,是逐细胞、逐数据算出来的,而不是一刀切。
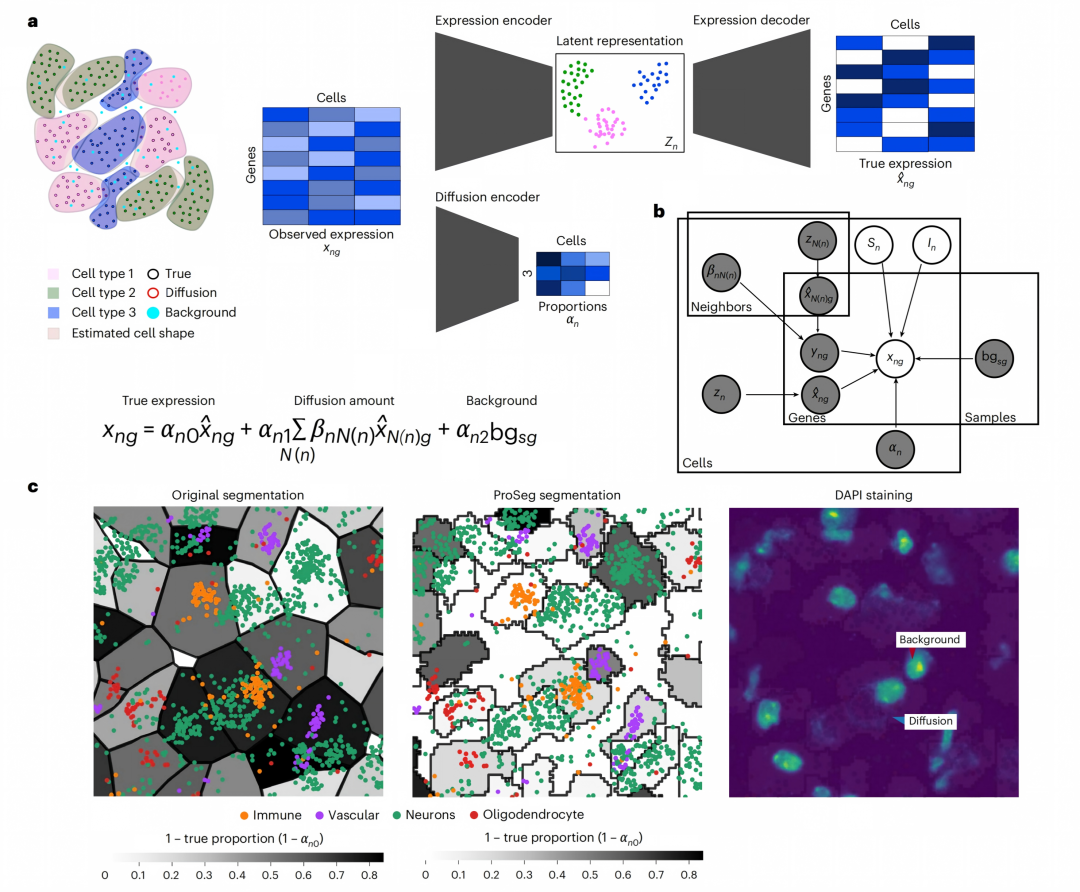
▲ 图1 resolVI 总览。a:算法示意——观察到的表达被拆为自身真表达、邻居扩散与背景三部分;b:概率图模型,zn 为细胞隐变量,N(n) 为邻居细胞;c:10x Xenium 小鼠脑区实例——中图为 ProSeg 分割,右侧 DPI 染色,箭头标注了一处免疫细胞与神经元边界不清导致的"扩散",以及血管细胞里零星神经元转录本构成的"背景"。
有几个设计细节值得划重点:
- 隐空间用高斯混合分布,而不是标准 VAE 的单峰正态。这让不同细胞类型在隐空间里天然分得更开,还支持半监督模式——把已有细胞类型标签接进先验,同时训练一个从隐空间预测细胞类型的分类器; - 批次效应的 Dropout 技巧:解码器吃批次 ID,编码器默认不吃,沿用 scVI 家族的经典操作,让表征尽量摆脱批次信息; - 为什么模型能"分辨对错":直觉是真实数据可以低维描述,而错配会让观测表达比真表达更复杂。最小化 ELBO 时,模型会主动把"解释不了"的分子分给背景或邻居组分; - 先验剔除可疑细胞:resolVI 会为每个细胞估计"真 counts 数",论文把真 counts 少于 20 的细胞视为低质量并在分析前剔除。
计算开销相当友好:所有实验在一块 Nvidia 3090 + 128 GB 内存的工作站上完成,最大的测试(140 万细胞、52 张切片)训练不到 6 小时。相比之下,Baysor 分割一张中等规模的切片要跑好几天。
三、实测一:小鼠脑切片,先证明"擦得干净、还不擦伤"
第一个测试是 10x Xenium 成像的正常小鼠脑切片(248 基因面板、约 13 万细胞)。三个层次的验证:
- 分型更清楚:resolVI 潜空间的 UMAP 把细胞类型分开的程度明显优于 PCA,scib 综合指标上也好于 scVI、scANVI 等常用方法; - 假表达被清掉:微胶质细胞在高密度脑区(下丘脑)曾被"看到"表达兴奋性神经元标志 Slc17a6——resolVI 校正后这一假阳性大幅下降,而这些细胞该表达的 Trem2 完整保留。去伪存真,两件事同时做到; - 真表达没被误伤:用小鼠脑单细胞参考数据定义"互斥基因对"后统计,假双阳性显著减少;但内皮细胞与 Lyz2(典型的髓系标志)的共表达被保留下来——文献确实报道过内皮细胞可以表达 Lyz2,只是单细胞参考里没测到。模型没有把数据硬塞进"教科书式"的细胞类型框框里。
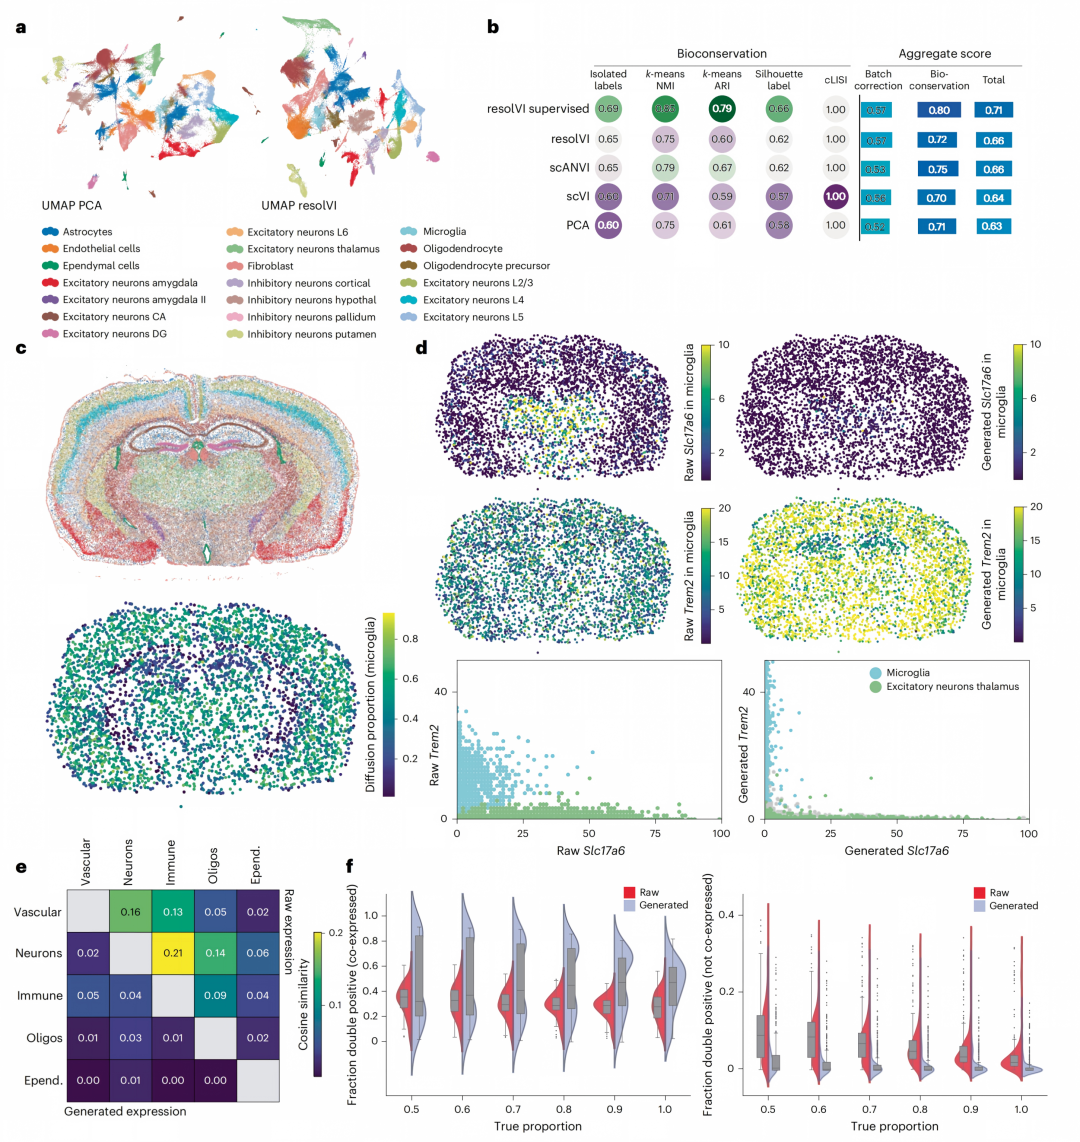
▲ 图2 小鼠脑实测。a/b:resolVI 潜空间(上)比 PCA(下)更能分开脑细胞类型,scib 指标显示 bioconservation 与批次校正总分均占优;c/d:微胶质细胞的 Slc17a6 假阳性在校正后显著减少、Trem2 保留,散点图对比 raw 与 generated 表达;e:细胞类型间余弦相似度矩阵,对角线下方为 resolVI 校正后、上方为原始数据,非对角块明显变暗;f:真共表达对(左)在校正前后比例相当,假共表达对(右)随"估计噪声比例"上升被系统性清除。
更妙的是模型的自洽性:resolVI 自己估计的"噪声比例"(α1+α2),与用"教科书知识"统计出的假双阳性率显著正相关——模型不看 marker 基因列表,也能估出哪些细胞"账目可疑"。
四、实测二:换什么分割都有效,但"底子"决定上限
第二个测试更狠:同一套肝癌组织(Vizgen MERSCOPE,550 基因、约 150 万细胞、两名患者),用 6 种分割算法各做一遍——Vizgen 原始、Cellpose 三种参数、以及表达感知的 Baysor 与 ProSeg——然后分别接 resolVI。
- 分割算法确实影响底子:表达感知的 Baysor、ProSeg 分割出的数据,假双阳性率本来就低于纯图像分割; - resolVI 在所有底子上都有效:无论哪种分割,接上 resolVI 后假双阳性都被压到相近的低水平,且与 Ovrlpy、ProSeg 自带的校正模块相比,resolVI 是唯一在清除错误信号的同时不破坏真实共表达的方法; - 上限取决于底子:初始分割越干净,resolVI 校正后残余的错误越少,Baysor 底子的最终假共表达最低。
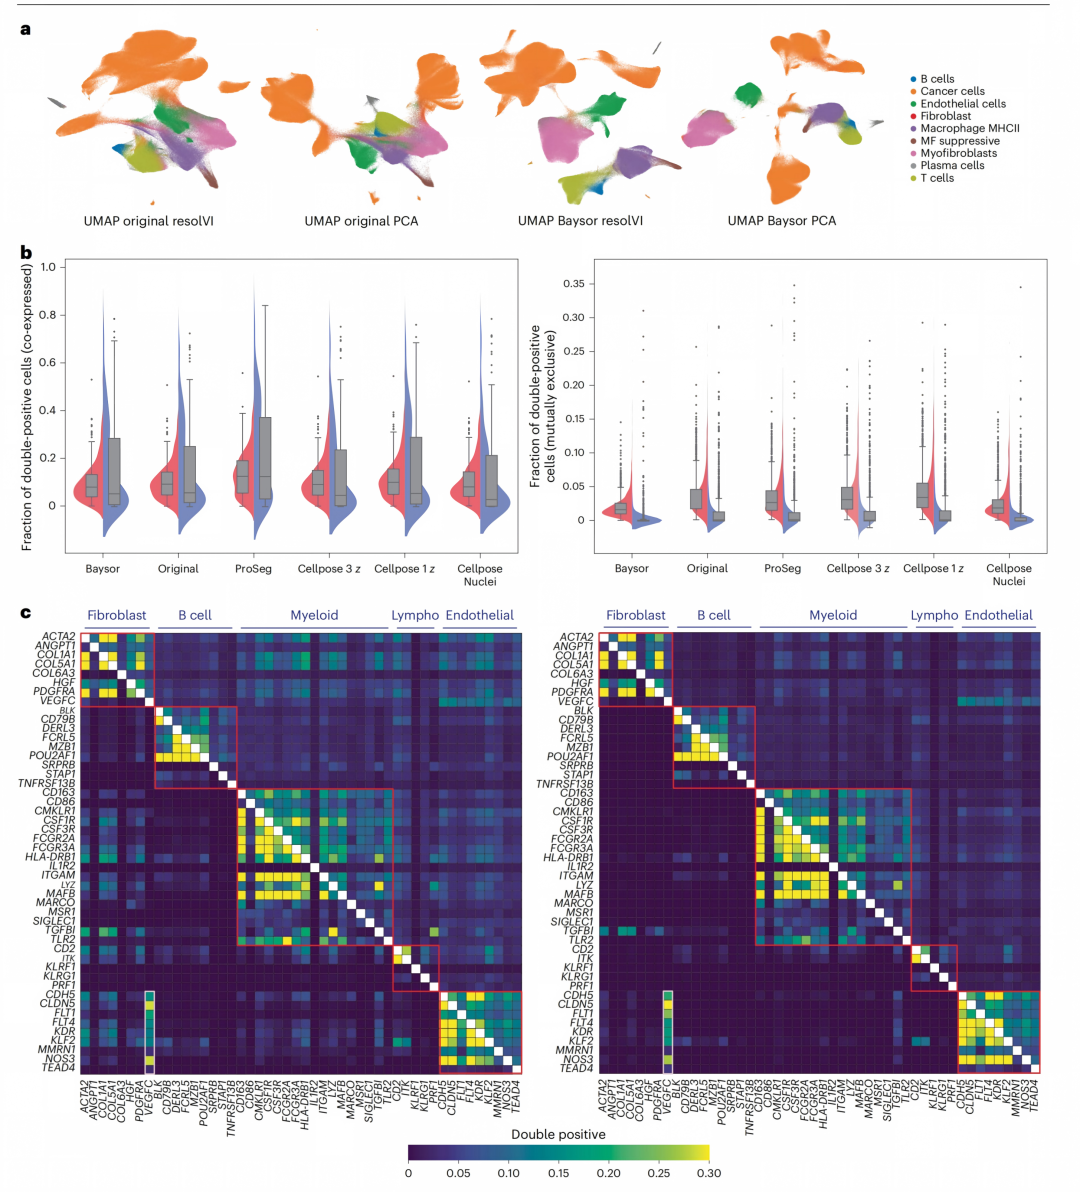
▲ 图3 六种分割 × resolVI。a:原始分割与 Baysor 分割下,resolVI 潜空间(左一、左三)相对 PCA 更能分开 B 细胞等亚群;b:六种分割下"真共表达对"(左)与"互斥基因对"(右)双阳性比例,resolVI 校正后(蓝/红)均显著下降;c:基因-基因共表达矩阵,对角线下方为 resolVI 校正后,红框为预期共表达,白框标出的 VEGFC-内皮共表达在肝癌中被保留(真实生物学)。
这里有一条很实用的经验:Baysor 虽然底子最干净,但会把只有极少分子的区域也分成细胞,"膨胀"细胞总数;作者因此推荐实际项目中用 ProSeg 做初始分割,再接 resolVI。
五、实测三:测序型大数据也"吃得下"
表达感知分割有个致命短板:基因数一多内存就爆炸,测序型 ST(动辄两万个基因)基本用不起。resolVI 不做分割,天然绕开了这个问题:
- Stereo-seq 小鼠脑冠状切面:超过 24,000 个基因、5 万细胞,全基因输入,运行不到 20 分钟、内存低于 30 GB。原始数据中 14.8% 的 Slc17a7 阳性细胞同时"表达"少突胶质细胞标志 Mbp,校正后这一比例降到 0.01% 以下;原本糊在一起的微胶质细胞也被清晰分出; - 10x Visium HD(8 μm bin):2 μm 分辨率、45 万个 bin、17,797 个基因,20 分钟训完。PCA 的 UMAP 里混成一团的神经元,在 resolVI 潜空间里分出了皮质 VIP、SST 抑制性、NPY 抑制性等亚群,且各自占据不同的空间位置。
也就是说,成像式和测序式两大路线、高基因数的大数据,resolVI 都能以很低的算力门槛覆盖。
六、实测四:肝癌微环境——把真信号从噪声里捞出来
前三关证明"擦得干净",第四关看"擦完之后能多看见什么"。数据是 Nanostring CosMx 的健康肝与肝癌对比(1,000 基因、120 万细胞),用 Baysor 重新分割后接监督模式 resolVI。
健康肝上,背景校正的效果一眼可见。肝小叶沿门管区到中央静脉存在 SAA1(门管区)与 GLUL(中央区)的经典分带,校正前后都看得到;但低表达的胆管细胞标志(SOX4、KRT13、EPCAM)在原始数据里"漂"到了中央静脉区——这些基因在中央区没有任何细胞类型表达,所以这种错位只能来自背景组分,resolVI 校正后它们乖乖回到门管区。
肝癌上,被保留下来的"意外共表达"才是大发现。健康肝里,髓系-胆管细胞间的假共表达被清除;但肝癌里这对共表达在校正后依然存在——具体源头是 SPP1 与 CD68:肿瘤相关巨噬细胞真实地高表达 SPP1(它是巨噬细胞与肿瘤细胞互作的关键介质)。同一个模型,既把健康组织里的噪声擦掉,又把肿瘤里的真实信号原样保留。
顺着这条线索,作者用 hotspot 模块 + resolVI 自带的差异表达检验(lvm-DE)拆解了肿瘤内部的空间结构:
- 肿瘤细胞存在两种空间状态:促炎区与免疫抑制区,各自携带不同的基因模块; - 免疫抑制区的肿瘤细胞与 SPP1+ 免疫抑制型巨噬细胞、S100A8/S100A9+ 中性粒细胞共定位;促炎区的肿瘤细胞与 IFI27/IFI6/CXCL9+ 促炎型巨噬细胞共定位; - T 细胞亚群(Treg、CXCL13-high CD8)只浸润促炎区,免疫抑制区几乎"没有 T 细胞"。
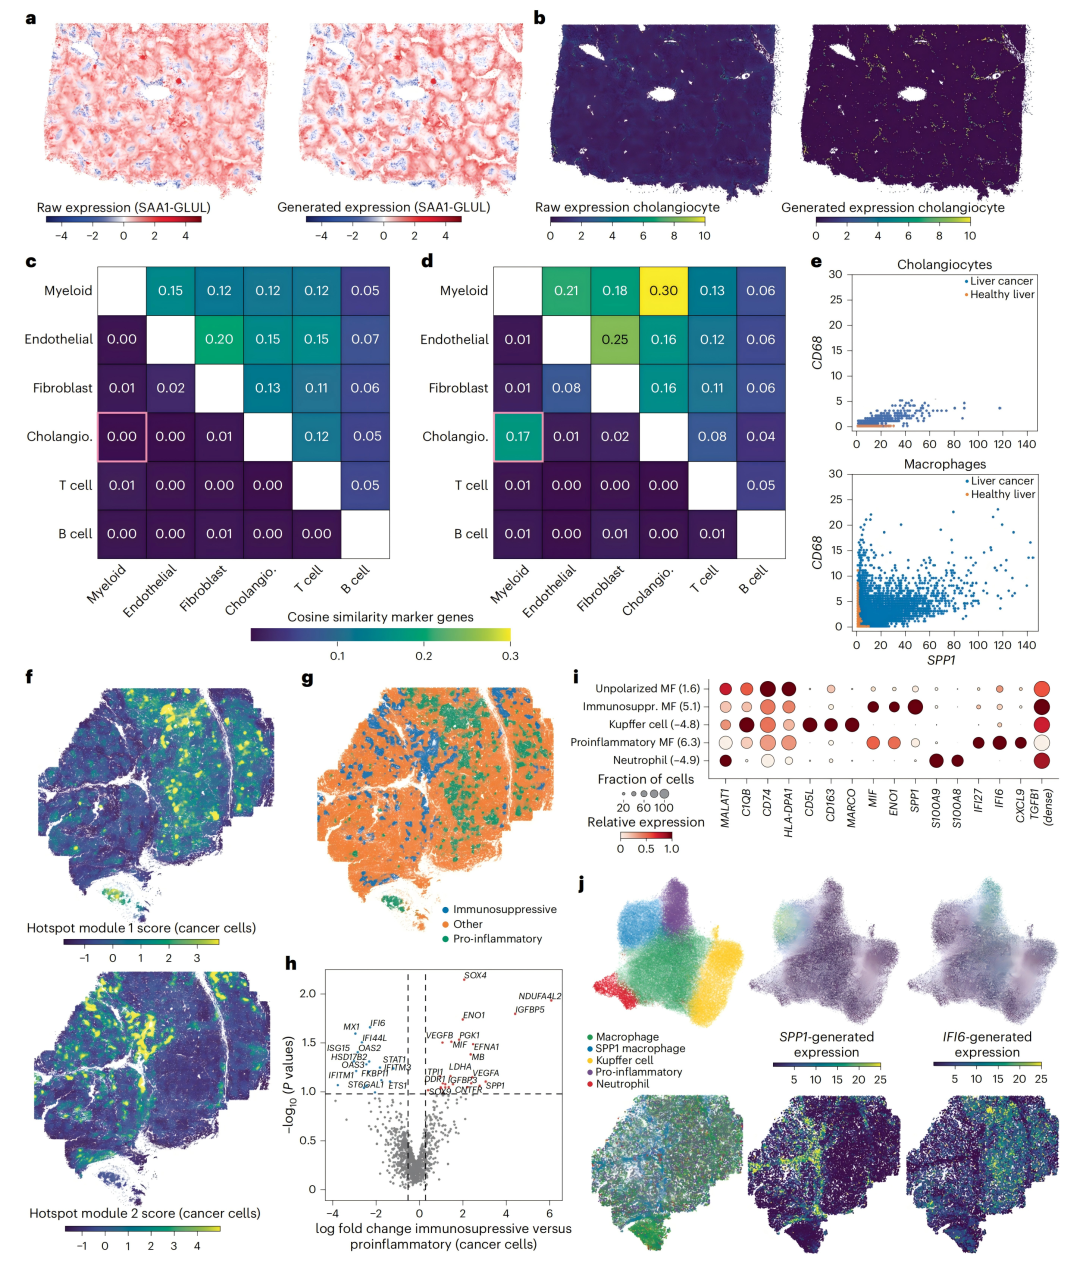
▲ 图4 人肝癌空间生态位。a:肝小叶 SAA1-GLUL 分带在原始与校正数据中均清晰;b:胆管细胞标志(SOX4+KRT13+EPCAM 之和)在原始数据中弥散、校正后回到门管区;c/d:健康肝与肝癌的细胞类型共表达矩阵,肝癌中胆管-髓系重叠持续存在;e:SPP1 与 CD68 在肝癌巨噬细胞中真实共表达、健康肝中互斥;f-j:两种肿瘤空间状态、巨噬细胞亚群与 SPP1/IFI6 生成的空间表达分布。
七、实测五:DSS 结肠炎——"看起来好了"不等于"真的好了"
压轴的测试把 resolVI 用到了纵向大队列:DSS 诱导的结肠炎小鼠,MERFISH 990 基因面板、52 张切片、140 万细胞,一天 0/3/9/21/35 五个时间点。训练加上把第 35 天作为查询集做参考映射(scArches 式"网络手术",不动已训好的参考模型),全程在一块 3090 上不到 6 小时。
细胞丰度层面,第 9 天偏离健康状态最远,第 35 天最接近——与原论文"几乎完全恢复"的描述一致。但 resolVI 往下多挖了一层:
- 隐窝顶端成纤维细胞(Fibro 2)搬家了。健康结肠里,Fibro 2 穿插在隐窝之间、直达隐窝顶端,给正在分化的肠细胞提供 Bmp 信号(Bmp2/5/7 在与结肠细胞共定位的 Fibro 2 中高表达),是隐窝轴正常成熟的关键;第 35 天,这些细胞从隐窝顶端消失,转而在黏膜下层聚集成团,与结肠细胞、TA 细胞的共定位显著下降,Bmp 信号同步降低; - 上皮成熟梯度被破坏。第 0 天,干细胞到结肠细胞的转变沿隐窝轴呈清晰梯度;第 35 天,这一空间组织整体紊乱; - 屏障基因出现代偿性上调。第 35 天,在结肠细胞高密度区域,促进屏障的基因(Cldn4、Cldn23、Tnfaip3、Il22ra1)显著上调——组织在"努力补漏"。
换句话说,显微镜下和丰度层面都"恢复"的结肠,在空间生态位层面仍然残留着炎症后的结构疤痕。这与临床认识高度吻合:炎症性肠病患者即使急性炎症被控制,屏障通透性问题仍长期存在。作者也指出,这一发现的人类版本有待人 IBF 样本的空间转录组验证。
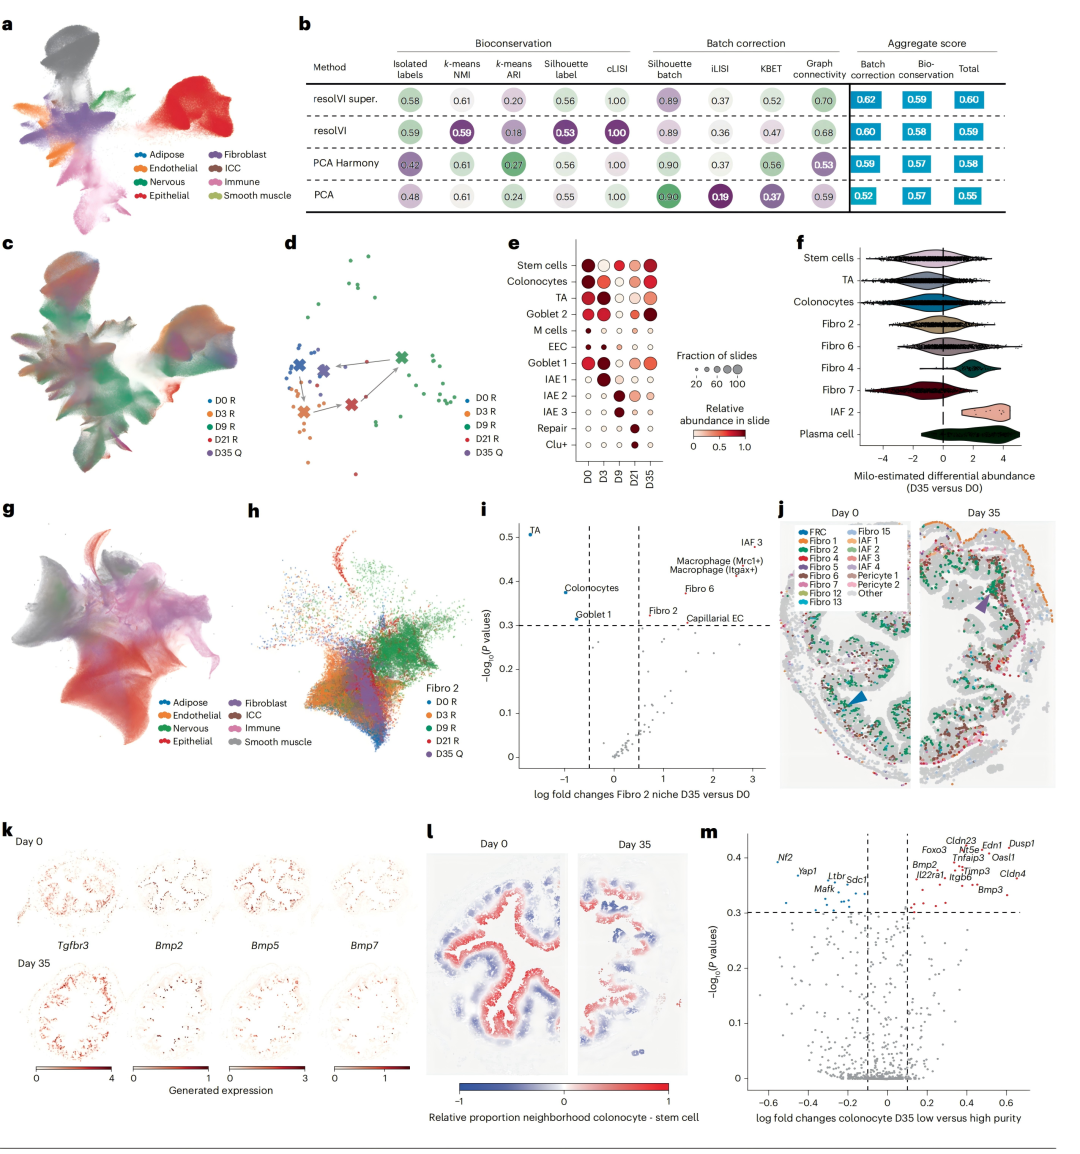
▲ 图5 DSS 结肠炎第 35 天的空间残留改变。a-f:半监督整合与各时间点细胞丰度,第 35 天整体最接近第 0 天但未完全复原;g-j:Fibro 2 的邻居组成随时间点改变,空间上从隐窝间穿插(第 0 天,蓝箭头)转为黏膜下层聚集(第 35 天,紫箭头);k-m:Fibro 2 的 Bmp 基因表达下降,结肠细胞成熟梯度紊乱、屏障基因代偿性上调。
八、给你的实操建议
结合全文,如果你手里有 ST 数据,resolVI 值得排进分析流程的位置是这样的:
- 定位:分割与定量的下游一步,输入任何算法产出的细胞 × 基因矩阵 + 空间坐标即可,与上游工具解耦; - 两种模式:无标签用无监督;有注释用半监督(标签进先验 + 隐空间分类器),还能输出细胞类型预测的不确定度; - 下游分析全家桶:内置 lvm-DE 差异表达检验、差异邻域丰度检验(论文里的肝癌分区与结肠炎生态位分析都靠它); - 参考映射:scArches 式网络手术,把新切片映射进已训好的参考模型,适合大队列纵向研究; - 算力:单卡 3090 起步即可,Stereo-seq/Visium HD 级别的数据分钟级训练; - 两个注意事项:①校正上限取决于初始分割质量,作者推荐 ProSeg 做分割(Baysor 膨胀细胞数);②先按模型估出的真 counts 剔除低质量细胞(论文阈值为 20)再训练。
代码已并入 scvi-tools 框架开源(github.com/scverse/scvi-tools),与 scVI、scANVI、TotalVI 等在同一生态里,上手成本对做过单细胞分析的人来说非常低。
写在最后:空间转录组这几年一路狂奔,把分辨率从 spot 级卷到亚细胞级,但"分子到底数在谁头上"这个最底层的问题,长期被当成上游工具的事。resolVI 的价值在于把这笔账从"分割算法的责任"变成"每个细胞可以显式建模的概率问题"——擦掉的是噪声,留下的是连单细胞参考都没见过的真实生物学。
论文信息:Ergen, C. & Yosef, N. ResolVI: addressing noise and bias in spatial transcriptomics. Nature Methods 23, 2003–2014 (2026). doi: 10.1038/s41592-026-03212-9