
 English
测不准、测不全、测不齐?Nature Methods 新模型 CytoVI 用概率生成模型统一抗体单细胞分析
流式、质谱流式(CyTOF)与 CITE-seq 已经能一次测几十到几百个蛋白,是临床免疫分型和基础免疫研究的主力。但技术噪声、批次效应、平台差异、抗体 panel 受限这四座大山,一直卡着下游分析。2026 年 10 月 Nature Methods 发表的 CytoVI,用一套概率生成模型把整合、缺失值插补、差异蛋白表达检验、细胞自动注释统一在一个框架里。它既建出了横跨 350 个蛋白的 B 细胞成熟图谱、锁定了免疫球蛋白类别转换的关键蛋白,又在 B 细胞非霍奇金淋巴瘤队列里挖出了疾病相关的 T 细胞状态。代码已开源,集成进 scvi-tools。
一、抗体单细胞数据为什么"特别难搞"
先说清楚难点,才能理解 CytoVI 到底解决了什么。
读数不准
:流式靠荧光强度,细胞间互相串扰(荧光溢漏)、信号动态范围有限;质谱流式免了串扰,但成本高、通量低。 批次效应重
:不同仪器、不同染色方案、不同抗体克隆,同一群细胞在不同批次里漂得亲妈都不认识。 蛋白维度受限
:一次最多测 50 来个蛋白(流式受荧光光谱重叠限制),想要更高维只能靠 CITE-seq 这类多组学,但又引入技术平台差异。 稀疏与缺失
:单细胞层面信号本就稀,panel 一换,同一蛋白在另一批里就根本没测——数据天然"缺一块"。
基因组单细胞数据(scRNA-seq)的稀疏来自随机 dropout,而抗体数据是高分辨率、近连续的测量,噪声结构完全不同。直接套用 scVI 这类为转录组设计的模型并不合适。
二、CytoVI 是什么:一个统一的生成模型
CytoVI 的核心思路是把"细胞该长什么样"用一个概率模型显式描述,所有下游任务都从这个同一个模型里"长"出来,而不是各做各的管线。
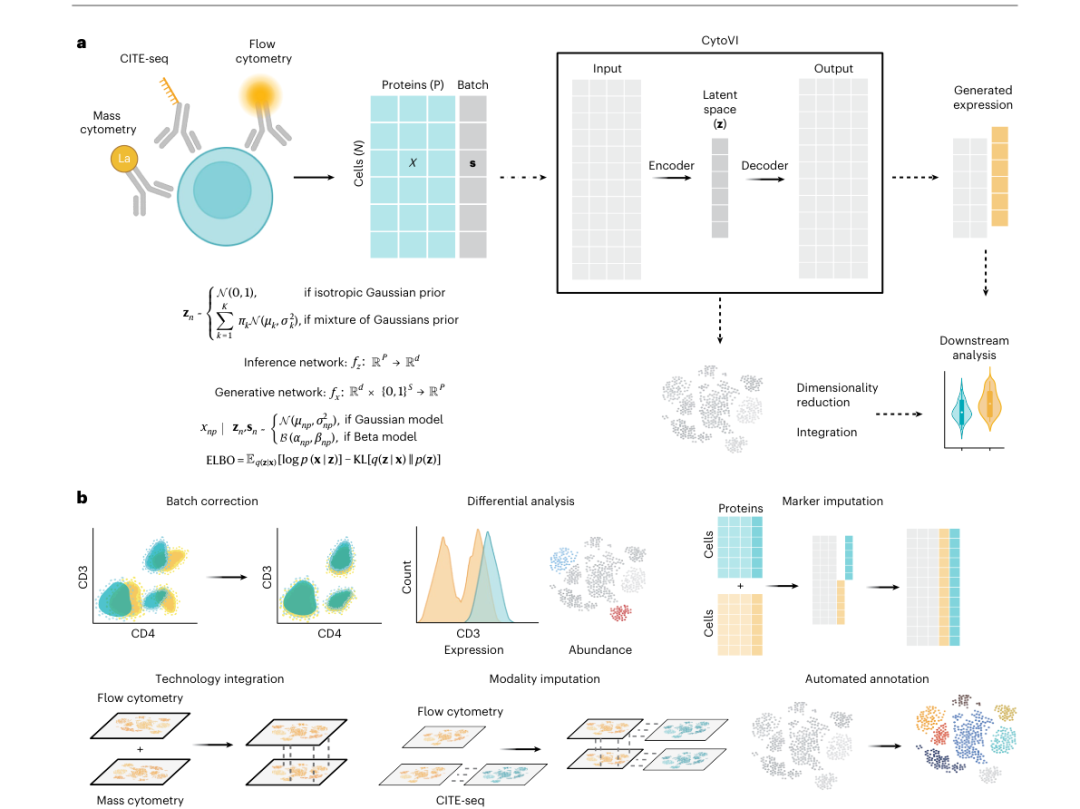
▲ 图1|模型总览:a CytoVI 是一个隐变量模型——蛋白表达作为观测,经过编码器映射到隐空间 z,解码器再重建表达并预测缺失蛋白;b 结构同时兼容高斯先验与高斯混合先验(捕捉多模态细胞状态),并显式建模批次与平台;c 一个模型同时输出四类能力:批次校正、标记物插补、差异分析、自动注释; d 下游对接 CellRank 等工具做轨迹推断。
三、一套模型,四类任务一次解决
传统做法往往"整合用 Harmony、插补用另一套、注释再手写规则"。CytoVI 把四件事装进同一个概率框架:
批次 / 平台校正
:隐空间里把不同仪器、不同 panel 的细胞对齐,Bio-conservation 指标不丢生物学。 标记物插补
:模型学会了蛋白间的联合分布,没测的蛋白也能从已测的"猜"出来,且带不确定性。 差异蛋白表达检验
:直接在生成模型下做统计检验,比事后 t 检验更稳。 自动注释
:隐空间聚类 + 参考标签,新数据进来自动打细胞类型标签。
也就是说,你不用再为每一步单独挑工具、调参数,一个模型从头管到尾。
四、Fig.2 可解释的潜空间:整合不丢生物学
模型好不好,先比整合质量。作者用一套标准 benchmark(Leiden 聚类、NMI、ARI、Silhouette、cLISI/iLISI、KBET、图连通性等)对比了 CytoVI、Harmony、FastMNN、cyCombine 和未整合基线。
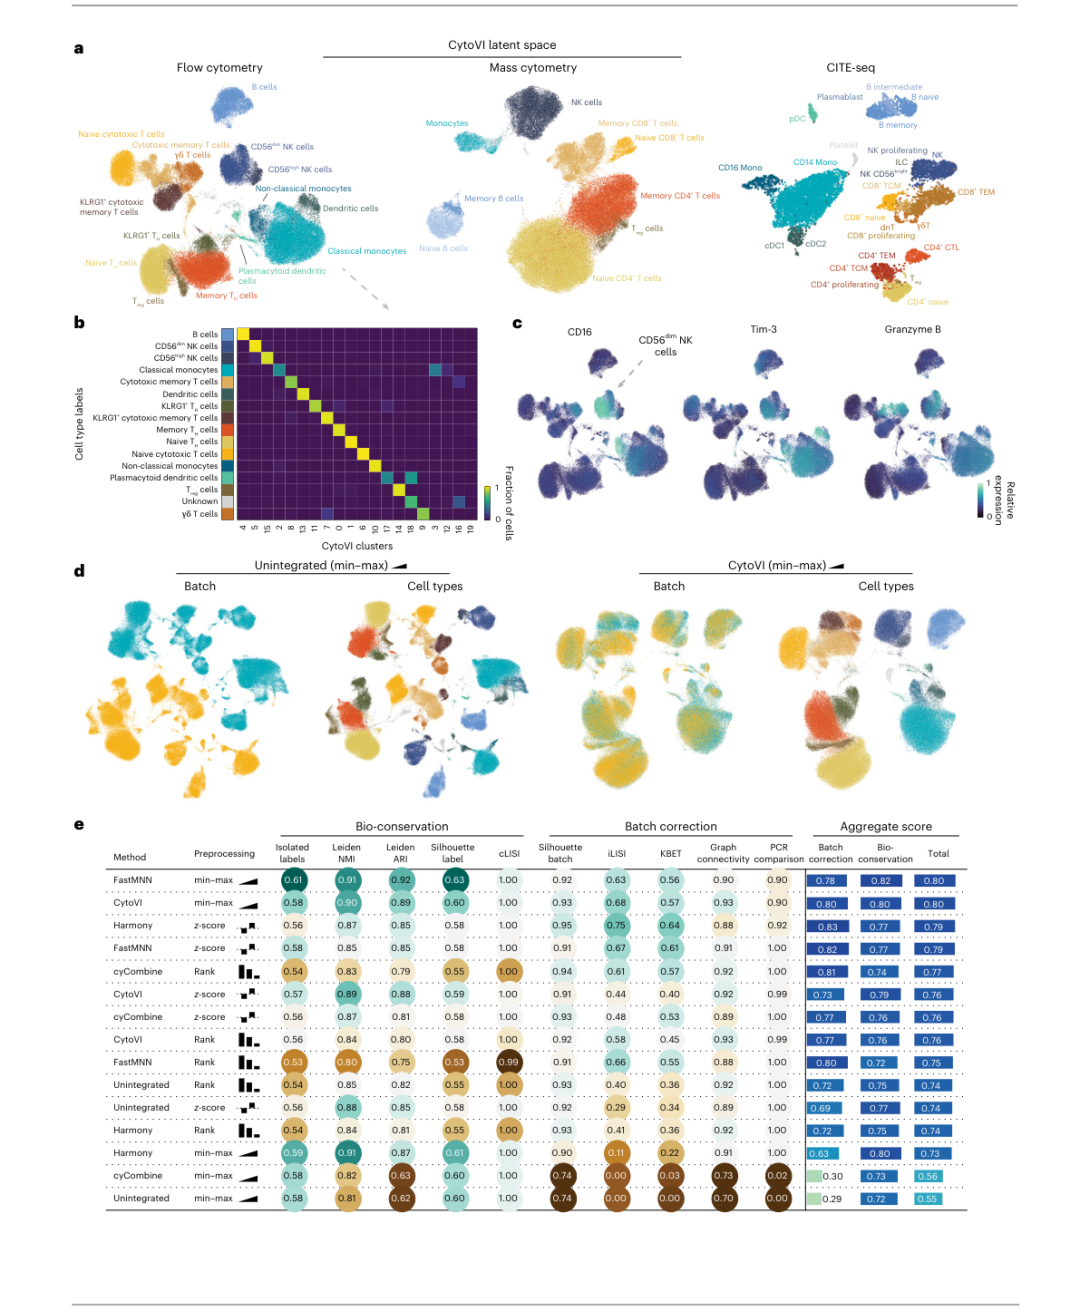
▲ 图2|可解释潜空间与基准对比:a CytoVI 隐空间 UMAP,细胞类型清晰可分;b 与流式、质谱流式、CITE-seq 多平台联合后的聚类效果; c 综合评分表——CytoVI 在 Batch correction 与 Bio-conservation 两项均居首,总体分数领先; d–e 与其他方法的逐项指标对比,CytoVI 在保留细胞类型结构的同时消去了批次。
关键结论:CytoVI 不只"抹平批次",还保住了细胞类型的真实结构——这正是生成模型相对纯判别方法(如 Harmony 的线性校正)的优势。
五、Fig.3 跨 panel 整合:350 蛋白 B 细胞成熟图谱
抗体 panel 一换,数据就断裂。CytoVI 做了一件很实的事:把两位供体、12 个相互重叠的 CyTOF panel 拼成一张统一的 350 蛋白 B 细胞成熟图谱。
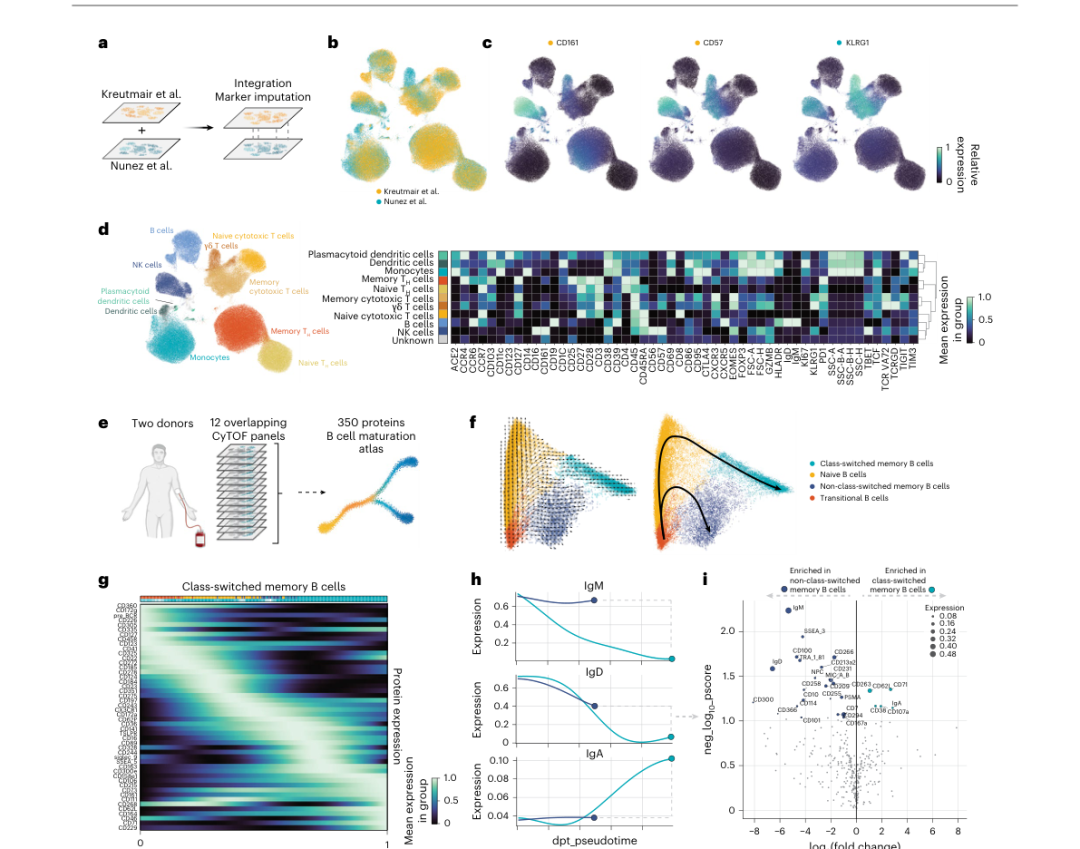
▲ 图3|跨 panel 整合与 B 细胞生物学发现:a 多 panel 数据经 CytoVI 对齐后的统一嵌入;b 叠加 Kreutmair、Nunez 等公开参考后的细胞类型注释; c 沿分化拟时序(pseudotime)的蛋白表达轨迹; d 类别转换记忆 B 细胞 vs 非转换记忆 B 细胞的差异蛋白; e–i 富集分析锁定与免疫球蛋白类别转换(class-switching)相关的蛋白,包括 IgD、IgM、IgA 等分化标志的动态变化。
这一步的产出是一张跨平台、跨批次的统一蛋白图谱,并直接指向了控制 B 细胞类别转换的关键调控蛋白——这是单 panel 分析很难看到的全局视角。
六、Fig.4 跨技术整合与插补:流式、质谱、CITE-seq 串起来
更硬核的是跨技术层面。CytoVI 能把流式(ground truth 标签)、质谱流式(imputed)、CITE-seq 三种技术的蛋白测量统一到同一空间,并互相补数。
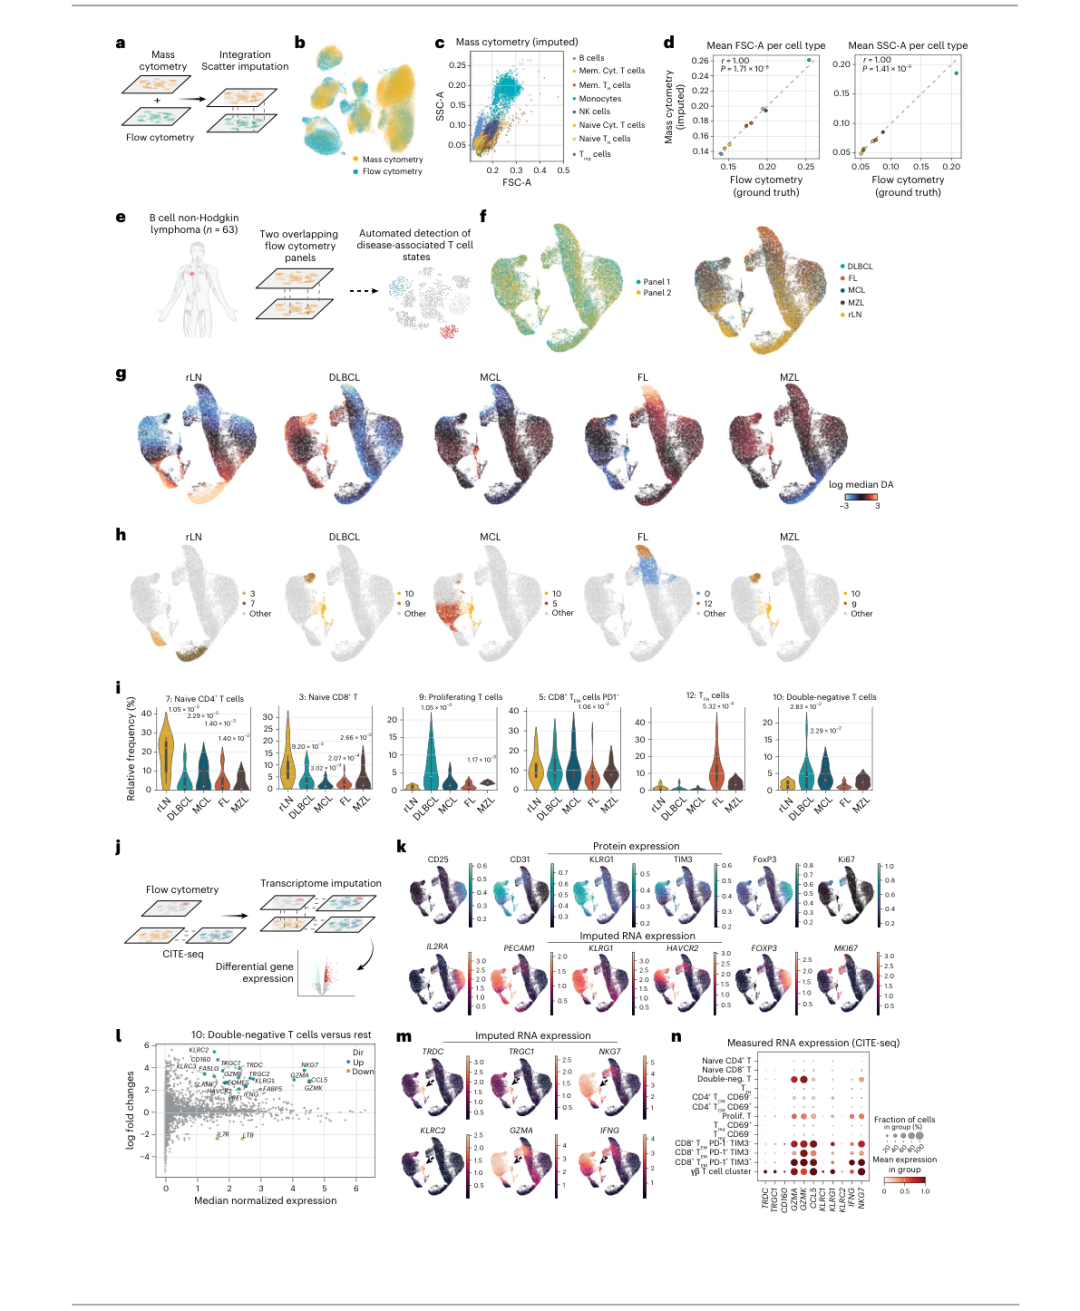
▲ 图4|跨技术整合、插补与淋巴瘤差异分析:a 流式与质谱流式散点插补,重建未测蛋白的二维分布(r 接近 1); b–d 流式↔质谱↔CITE-seq 的模态插补与整合; e–g 自动检测的疾病相关 T 细胞状态; h–m 在 B 细胞非霍奇金淋巴瘤(n=63)中,与正常淋巴组织(rLN)相比,双阴性 T 细胞、增殖 T 细胞、TFH、CD8+ TEM 等状态的相对频率与差异蛋白(如 NKG7、GZMA、IFNG、TRDC 等细胞毒/耗竭标志)显著改变; n 基于 CITE-seq 的转录组插补验证。
七、在淋巴瘤里挖出"疾病相关 T 细胞状态"
上面那张图最有临床味道的是 h–m 部分。作者把 63 例 B 细胞非霍奇金淋巴瘤(DLBCL、FL、MCL、MZL)和正常淋巴组织放一起做差异分析,自动识别出一批在肿瘤中异常富集的 T 细胞状态:
双阴性 T 细胞(Double-negative T cells)、增殖性 T 细胞显著上调; TFH 样、CD8+ TEM(PD-1−/TIM3− 与 PD-1+/TIM3+ 亚群)的频率和标志表达随亚型改变; 细胞毒/耗竭相关蛋白(NKG7、GZMA、GZMK、IFNG、TRDC、KLRG1 等)在肿瘤微环境中重塑。
这些状态过去靠人工设门很难系统捕捉,CytoVI 用统一模型把它们"自动浮现"出来——对免疫微环境研究是直接可用的抓手。
八、Fig.5 自动诊断血液恶性肿瘤:CLL 分类达 AUC 0.74
最后落到临床。作者用 700 万细胞的临床 CLL 数据训练参考模型,再对 3100 万细胞的查询数据做自动肿瘤负荷分类,并与临床医生标注对照。
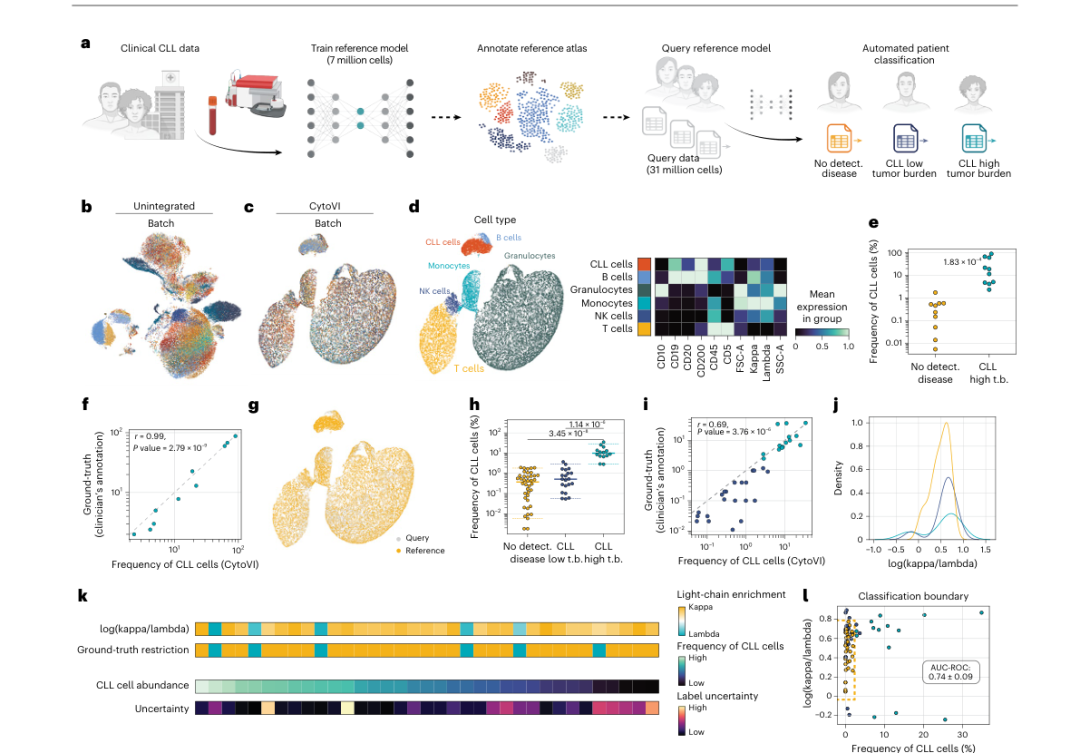
▲ 图5|自动化血液恶性肿瘤诊断:a 工作流——参考图谱注释 + 训练参考模型 → 自动患者分类; b–g 慢性淋巴细胞白血病(CLL)细胞频率的自动估计与临床标注高度一致(r 最高 0.99); h–j κ/λ 轻链限制分析,AUC-ROC 达 0.74±0.09; k–l 标签不确定性(label uncertainty)能标出低肿瘤负荷与未检测样本,提示人工复核。
亮点在于 label uncertainty 机制:模型不光给分类,还告诉你"哪些样本它没把握"——这种可解释、可质疑的输出,正是临床落地最需要的。
九、结语:为什么 CytoVI 值得关注
回到开头那四座大山——噪声、批次、平台、panel 受限。CytoVI 没有给出又一个"单独好用"的工具,而是用一个概率生成模型把它们统一收编:整合、插补、差异检验、注释一次完成,而且输出带不确定性、可解释、可质疑。
对做免疫分型、肿瘤微环境、临床流式诊断的团队,这意味着:
多批次、多 panel、多技术的数据,终于能放进同一个分析框架; 标注稀缺时,插补与自动注释能直接补位; 模型开源、进 scvi-tools,复现和二次开发门槛低。
如果你手上是流式或 CITE-seq 数据、正被批次和 panel 割裂折磨,CytoVI 值得作为新的 baseline 试一试。
Nature Methods 2026(doi:10.1038/s41592-026-03224-5)。