
 English
分错细胞,比测序更致命:Nature Methods 新工具 resolVI 给空间组学"降噪"
一句话看懂:亚细胞分辨率的空间转录组,真正拖后腿的往往不是测序深度,而是"把 RNA 分子分给了错误的细胞"。2026 年 9 月 Nature Methods 上线的 resolVI,把每个细胞观测到的表达拆成"真表达 + 邻居串门 + 背景"三笔账,用一个概率模型把错分的分子还回去,顺带校正批次效应。它是开源的,直接挂在 scvi-tools 里。
空间转录组(spatial transcriptomics,ST)这几年火得很快。从 10x Xenium、Nanostring CosMx 这类成像法,到 Stereo-Seq、Visium HD 这类测序法,分辨率已经压到亚细胞甚至 2 微米。"测得准"这件事,硬件厂商已经替你解决了大半;但"分得对",还悬在半空。
原因很简单:这些技术给出的不是"细胞",而是分子在组织切片上的坐标。要得到每个细胞的表达谱,中间必须插一步——细胞分割(segmentation):把平面划成一块块近似细胞的区域,再把区域里的分子归拢计数。这一步做得好不好,直接决定后面所有分析的可信度。
问题在于,组织里的细胞挤在一起、边界模糊、形状不规则。于是分割算法常常把邻近细胞的分子算到自己头上。这种"串门"造成的后果很隐蔽:你会看到本不该同时出现的基因在同一细胞里"共表达",进而得出"存在某种新细胞状态"的结论——而这可能只是分割误差造出来的幻影。
resolVI 要解决的,就是这最后一段路的系统性偏差。
一、误差不是一种,而是三种叠在一起
论文把观测到的表达矩阵拆得很干净。对第 n 个细胞、第 g 个基因,观测到的计数大致来自三部分:
真表达
:这个细胞自己真正转录出来的 RNA; 邻居扩散(diffusion)
:来自空间上相邻细胞、却在分割或组织处理中被"漏"进来的分子; 背景(background)
:整张切片上普遍存在的非特异性信号,每个样本一个常数项。
前两项用负二项分布建模,因为真实表达和扩散都带有过离散特征;背景项假设没有过离散,用泊松分布。三者按各自的权重 α 相加,就还原出观测值。
这个思路的高明之处在于:它不跟分割算法"抢活"。resolVI 明确站在任何分割算法下游,拿你已有的表达矩阵当输入,只做一件事——判断哪些计数可疑,并把它们重新分配。 换句话说,你不需要换掉现有的分割流程,只要在后面接一层校正。
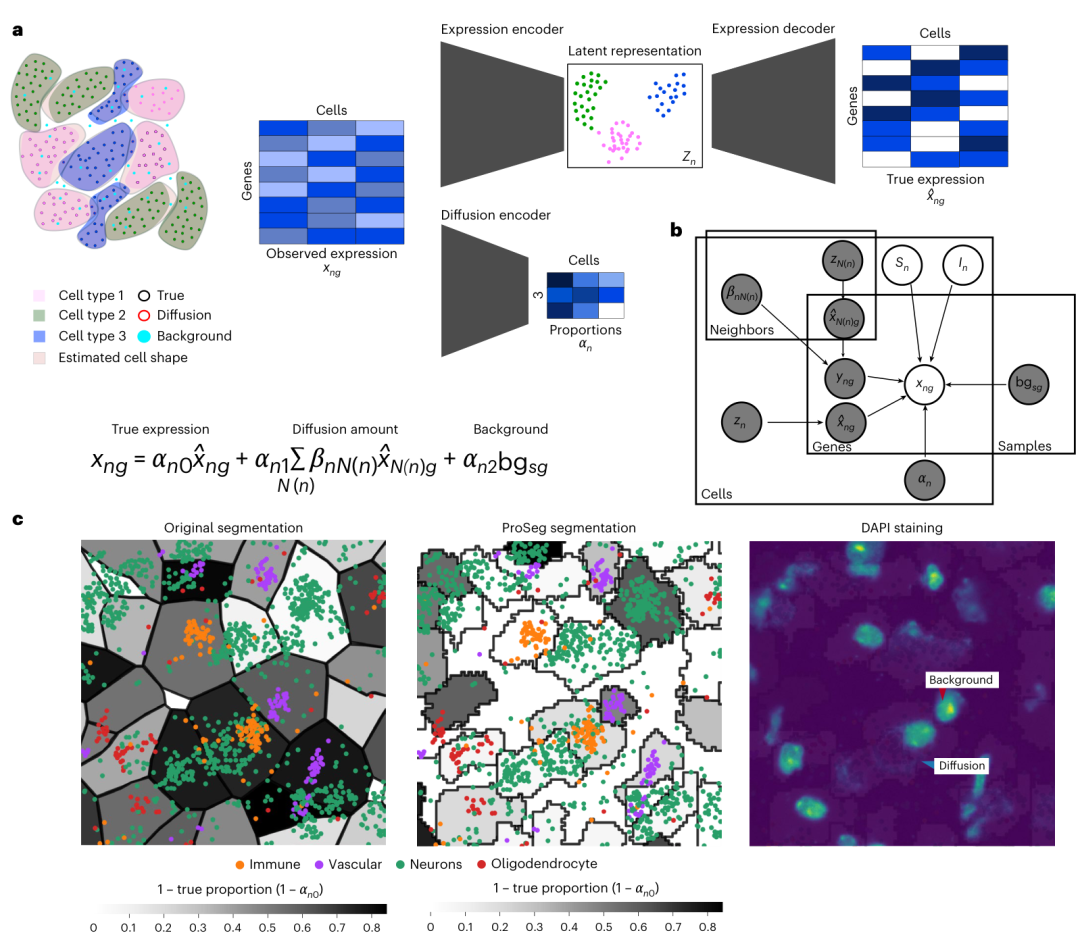
▲ 图1 | resolVI 总览。a,算法示意:分割无法完全刻画真实细胞形状,导致分子错配,再叠加非特异性背景;潜变量编码后分别估计"真表达""扩散""背景"三部分。b,概率图模型(板模型)。c,小鼠脑 10x Xenium 局部:原始分割与 ProSeg 分割对比,并标注"扩散"与"背景"两类典型污染。
二、它是怎么"拆账"的:一个带高斯混合先验的 VAE
模型主体是变分自编码器(VAE),由三个神经网络分工:
表达编码器(expression encoder)
:从观测计数推断细胞的低维状态; 表达解码器(expression decoder)
:由状态生成"真表达"; 扩散编码器(diffusion encoder)
:估计每个细胞里真表达、邻居、背景三部分各占多少权重。
一个关键设计是:潜变量的先验用高斯混合分布,而不是常规的单峰分布。 这不是为了好看。单峰先验会把所有细胞压在一团,细胞类型之间难以分开;混合分布天然对应"细胞类型是离散的"这一生物学事实,因此能更清楚地区分细胞亚群。也正因为有了混合先验,模型可以很方便地接入已知的细胞类型标签——这就是它的监督模式;不接标签,就是无监督模式。
另一个容易被忽略的点是批次效应。解码器接收细胞的批次 ID,编码器默认不接收,这种"非对称"设计能让潜空间尽量与批次无关,从而在整合多张切片、多个样本时抑制技术差异。
而从直觉上说,为什么最小化 ELBO 就能把错分的分子挑出来?因为模型隐含地要求:数据可以用一个低维编码来描述。 分割误差会让观测表达变得比真实表达更"复杂"、更杂乱。于是优化过程会自发地把那些"讲不通"的分子,推给背景项或邻近细胞——这正是我们想要的结果。
实现上,resolVI 支持 GPU 加速。作者用的是一台 Nvidia 3090、128 GB 内存的工作站。
三、小鼠脑:把神经元的基因,从微胶质细胞里清出去
第一个案例是 10x Xenium 测的一张正常小鼠脑切片,248 个基因、约 13 万个细胞。原始数据由原作者用"细胞核分割 + 膨胀"得到,本质是给每个核套一个凸多边形,再把多边形里的分子计数。
作者先看了一个很直观的现象:扩散比例高的区域,恰好是细胞密集的皮层和丘脑。 这符合预期——细胞越挤,越难分割干净。
真正有说服力的是微胶质细胞(microglia)。校正前,这些细胞能稳稳表达 Trem2(微胶质标志基因),这没问题;但在下丘脑这个"高扩散"区域,它们同时呈阳性于 Slc17a6——一个兴奋性神经元的标志基因。一个微胶质细胞表达神经元标志,大概率不是生物学,而是分割把邻近神经元的分子算进来了。
resolVI 校正后,Slc17a6 的假阳性被大幅削减,而 Trem2 依旧保留。这就是"纠错"和"误伤"的区别:它没有把信号一刀切地削平,而是保住了该留的、去掉了不该有的。
用 scib-metrics 做量化,以"估计真表达比例高于 0.8 / 低于 0.8"作为高质量与低质量批次的代理,resolVI(监督)的综合评分达到 0.71,高于 PCA 的 0.63,也优于 scVI 与 scANVI。这意味着它不仅在"分得开细胞类型"上更好,在"把不同数据质量的同类细胞拉到一起"上也更好。
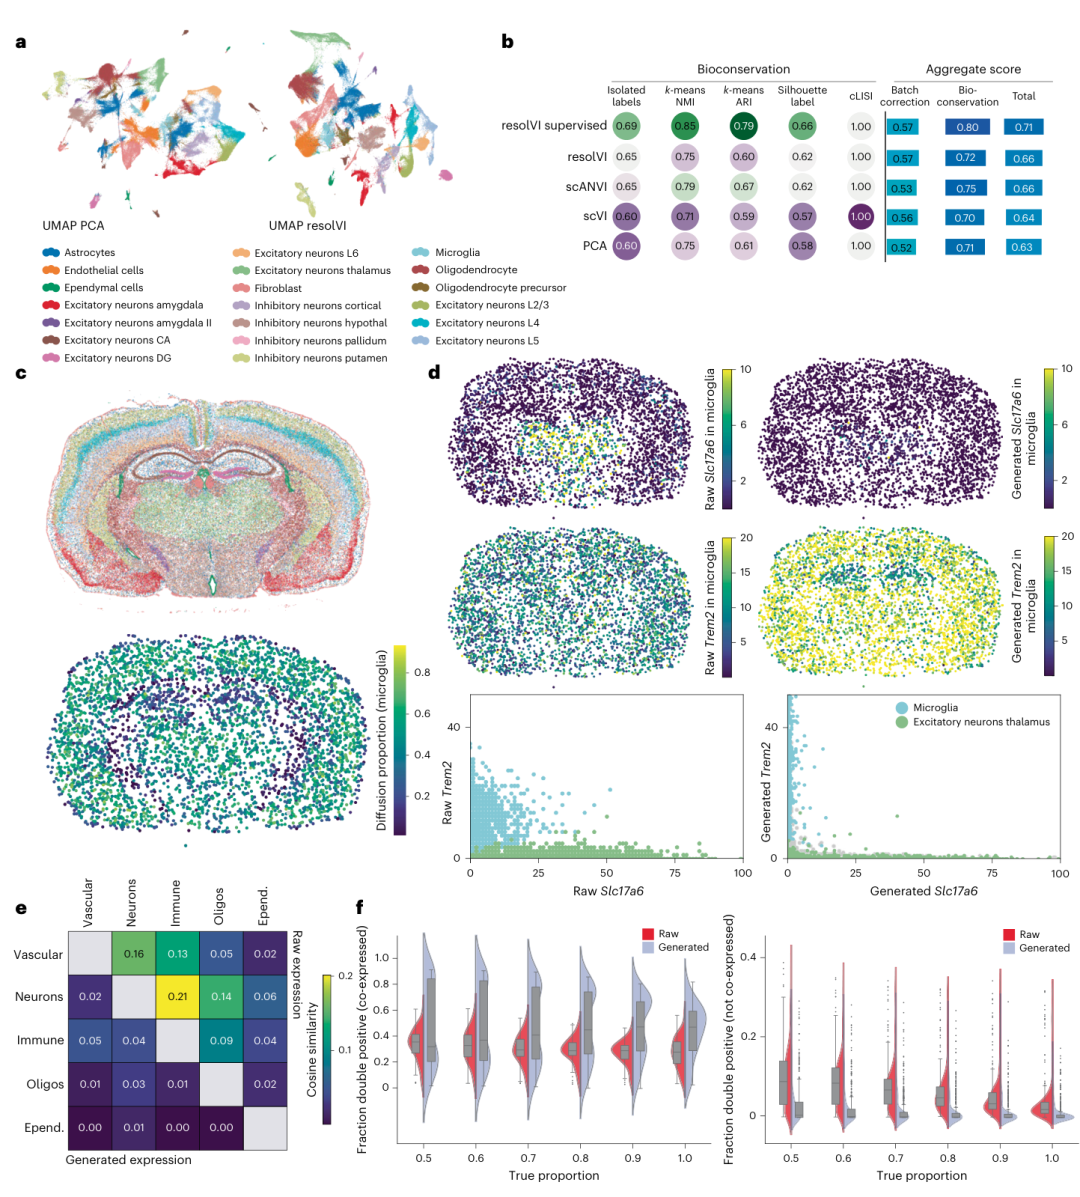
▲ 图2 | resolVI 校正小鼠脑的表达偏差。a,PCA 与 resolVI 潜空间的 UMAP 对比。b,scib-metrics 各项评分。c,细胞类型空间分布(上)与微胶质细胞的扩散比例(下)。d,仅看微胶质细胞:Slc17a6 与 Trem2 在校正前后的空间表达与散点关系。e、f,标记基因互斥性与共表达比例的定量。
四、一个必须讲清楚的前提:校正效果,取决于初始分割
这是全文最重要、也最容易被忽略的一条结论:resolVI 不是万能的,它只能在"初始分割还算靠谱"的基础上把误差压小,不能凭空变出正确分割。
作者拿六种分割结果做了系统比较:Baysor、原始分割、ProSeg、Cellpose 3 z、Cellpose 1 z、Cellpose Nuclei。结论是:
Baysor 的假共表达最低
,与 resolVI 组合效果最好; 但 Baysor 倾向于把细胞切得很碎,很多细胞只含极少数分子,会虚增细胞数量; 因此实践建议是:初始分割用 ProSeg,再跑 resolVI 校正——这是精度与细胞数合理性的折中。
换句话说,resolVI 校正的是"量化环节的漏",而不是"分割环节的错"。这两类误差性质不同,别指望一个后处理模型把上游问题全兜住。
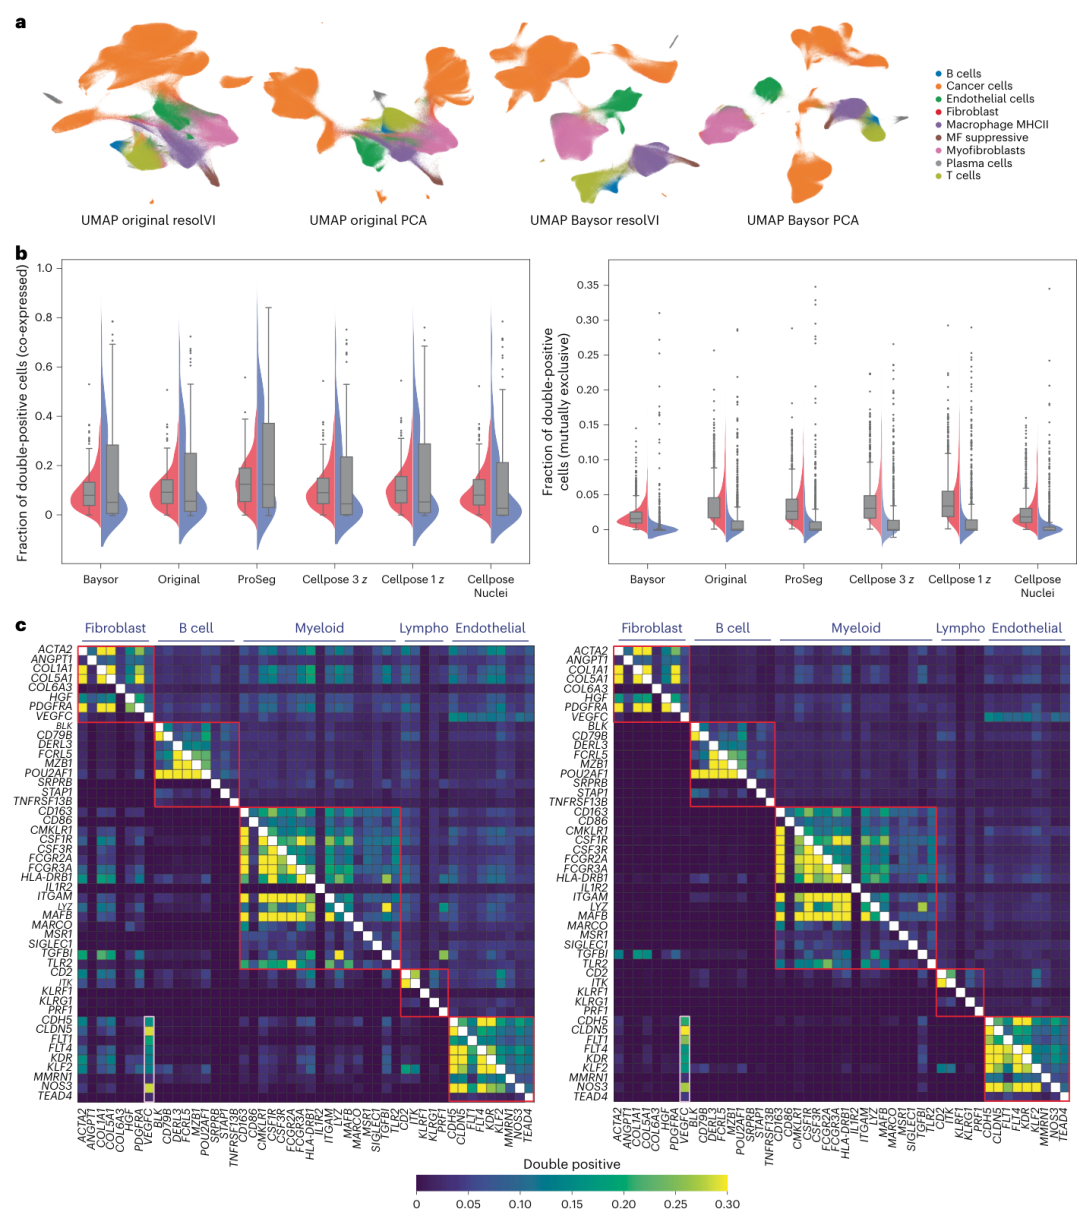
▲ 图3 | 性能依赖初始分割。a,原始分割与 Baysor 分割下,resolVI 与 PCA 的 UMAP 对比。b,六种分割算法在校正前后,"共表达基因"与"互斥表达基因"双阳性细胞比例的变化。c,标记基因两两共表达矩阵:对角线以上的红块是"应当共表达"的基因对,块外区域本不该共表达。
五、人肝癌:让低表达标志物"各归其位"
第三个案例换到了真实的临床比较场景:健康肝与肝癌,Nanostring CosMx,1000 个基因、120 万个细胞。作者用 Baysor 重新分割,再用 resolVI 的监督模式做进一步分析。
肝细胞沿肝小叶有明显的分区(zonation):SAA1 标在门静脉周围(periportal),GLUL 标在中央静脉周围(pericentral)。这一梯度在校正前后都清晰可见——说明 resolVI 没有破坏真实的空间结构。
真正体现价值的是低表达标志物。胆管细胞标志 SOX4、KRT13、EPCAM 表达量本来就比 SAA1、GLUL 低得多。校正前,这些基因在中央静脉区也被"检出",看起来像是到处都有胆管细胞;校正后,它们干净地回到门静脉周围。作者特别指出:这类错误信号并非来自邻近细胞的真实表达(中央静脉区根本没有细胞表达它们),而是来自背景项——这恰好证明了模型中 α₂(背景)这一项的必要性。
更有意思的是癌症样本里的"残留共表达"。在健康肝里,髓系与胆管细胞标志的意外共表达在校正后大幅下降;但在肝癌里,这种共表达依然存在。追到具体基因对,是 SPP1 与 CD68 等髓系标志的共表达。进一步看,这是肿瘤相关巨噬细胞(TAM)真实表达 SPP1 的结果——SPP1 是介导巨噬细胞与肿瘤细胞互作的关键分子。
换句话说:校正该消掉的假信号消掉了,该留下的真生物学留下了。 这正是判断一个降噪方法是否可靠的核心标准。
在此基础上,作者用 hotspot 算法在肿瘤内找到两个空间共表达模块,对应促炎与抗炎两种癌细胞生态位,并把 lvm-DE 方法适配到 resolVI 的生成模型上做差异表达,刻画了不同生态位下癌细胞、髓系、T 细胞的表型差异。
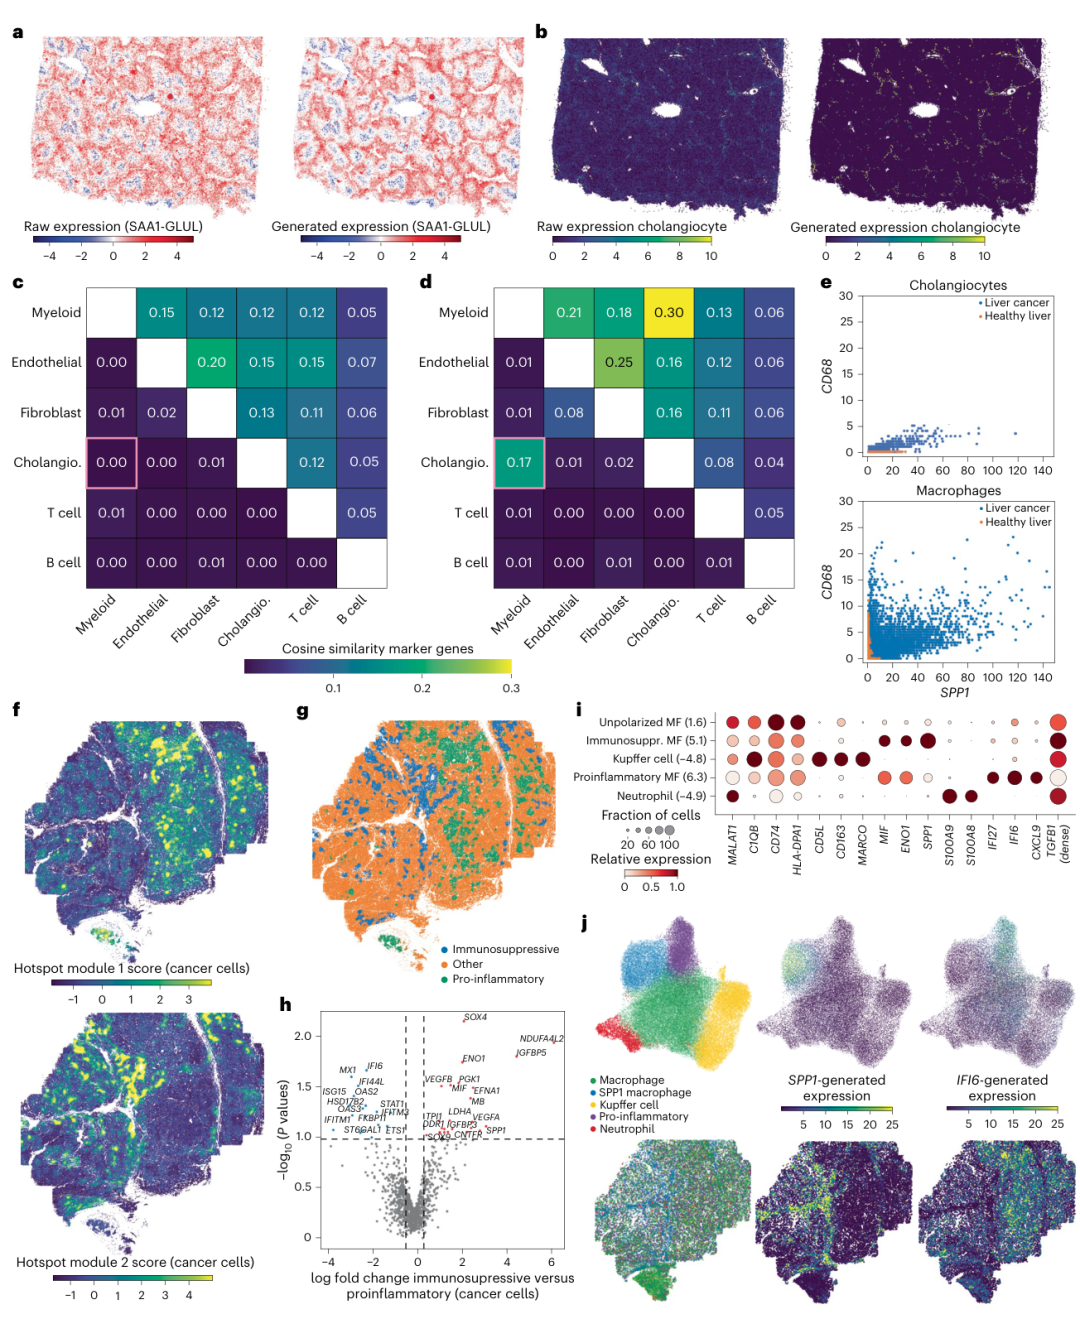
▲ 图4 | resolVI 揭示人肝癌中的不同生态位。a,SAA1 与 GLUL 的差异显示门静脉—中央静脉梯度(左原始、右校正)。b,胆管细胞标志(SOX4、KRT13、EPCAM 之和)在校正前后。c、d,健康肝(c)与肝癌(d)的标记基因余弦相似度矩阵。e,SPP1 与 CD68 的散点关系。f、g,两个 hotspot 模块评分与巨噬细胞表型。h,差异表达火山图。i、j,髓系亚群与 SPP1、IFIG 生成表达的空间分布。
六、DSS 结肠炎:140 万细胞、52 张切片里的"迷路"成纤维细胞
最后一个案例规模最大,也最贴近纵向研究:DSS 诱导的结肠炎,140 万个细胞、52 张切片,横跨第 0、3、9、21、35 天。resolVI 全部训练完成不到 6 小时——考虑到单张切片用 Baysor 分割可能要跑好几天,这个额外开销几乎可以忽略。
这里用到了 resolVI 的半监督模式:把第 35 天当作"查询集",映射到已有的参照数据上,同时输出细胞类型预测的不确定性。有了不确定性,就能做两件下游的事:
空间邻域嵌入
:统计每个细胞周围 30 个邻居的细胞类型构成,得到一个"邻域丰度向量",再做 UMAP; 邻域组成差异检验
:用贝叶斯双边检验比较不同时间点,并校正多重比较。
结果指向一个很具体的生物学故事。Fibro 2(隐窝顶端成纤维细胞)在第 0 天散布在结肠隐窝之间,一直延伸到每个隐窝的顶部;到第 35 天,它们却在黏膜下层聚成团,并与其它成 Fibro 共定位。
随之而来的是信号变化:
第 35 天,Fibro 2 中 Bmp2、Bmp5、Bmp7 表达下降——这些 Bmp 基因对结肠细胞沿隐窝轴的正常成熟至关重要; 同时,结肠细胞与干细胞之间的梯度被打乱,上皮层组织结构出现紊乱; 而在结肠细胞密集的区域,屏障相关基因 Cldn4、Cldn23、Tnfaip3、Il22ra1 表达升高。
按常理,第 35 天应当接近"恢复健康"。但数据说:位置回来了,功能没完全回来。 这种"结构恢复但信号错位"的细节,恰恰是靠单细胞分辨率的空间分析才能捕捉到的。
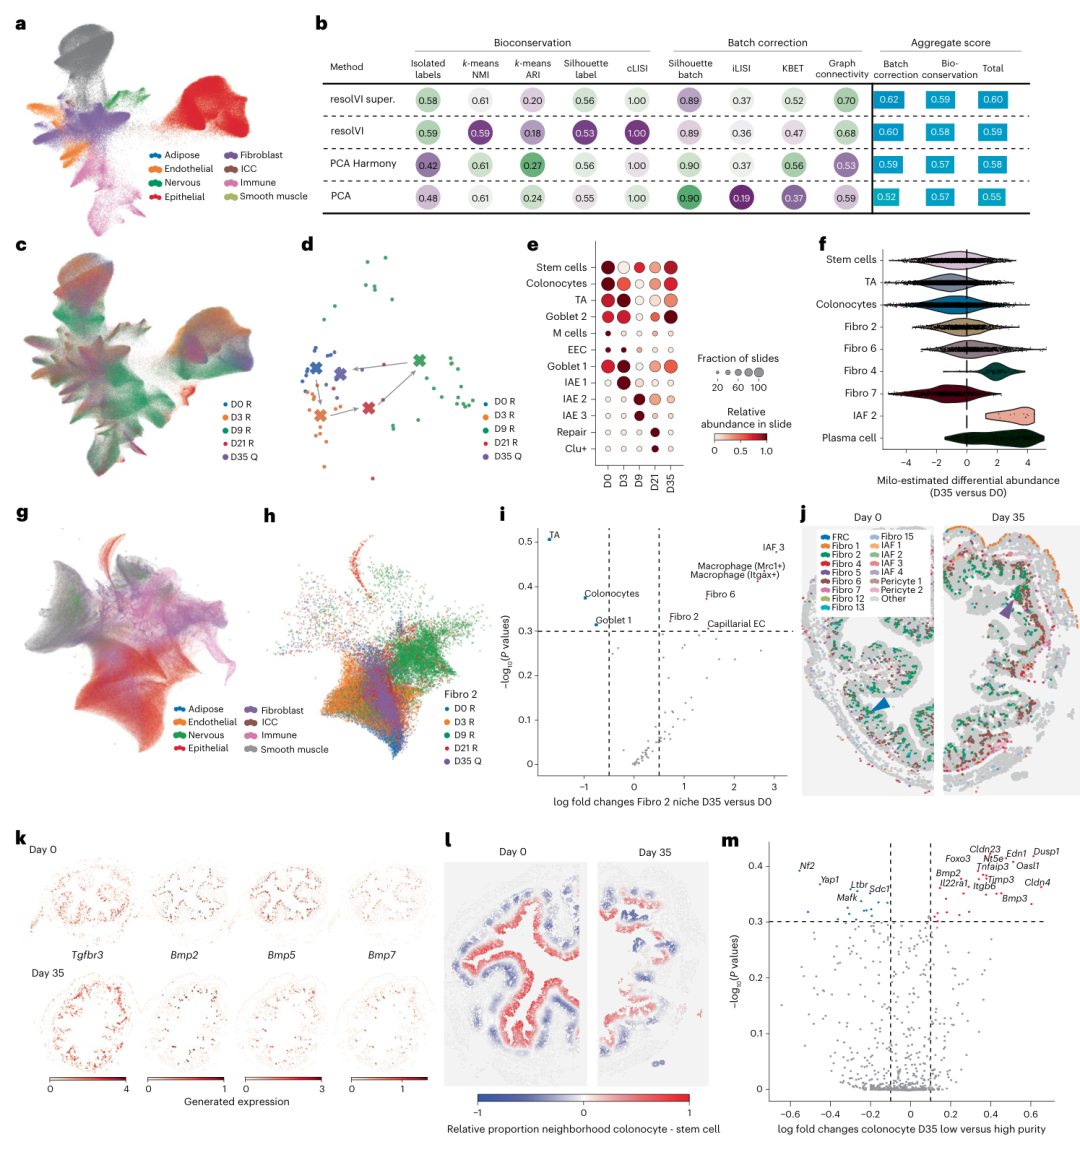
▲ 图5 | DSS 结肠炎后结肠上皮的改变。a—d,整合后的 UMAP 与切片层面细胞类型频率。e,各时间点上皮细胞类型的相对丰度。f,Milo 邻域差异丰度。g、h,邻域组成 UMAP。i,Fibro 2 邻域组成的差异。j,Fibroblast 在第 0 天与第 35 天的空间分布。k,Tgfbr3 与 Bmp2/5/7 的生成表达。l、m,结肠细胞—干细胞相对比例与差异表达。
七、把关键数字放在一起
小鼠脑(10x Xenium)
248 个基因、约 13 万个细胞 scib 综合评分:PCA 0.63 → resolVI(监督)0.71
小鼠脑(Stereo-Seq)
2.4 万+ 基因、5 万+ 细胞 Slc17a7
与 Mbp 的假共表达:14.8% → 低于 0.01% 运行 不到 20 分钟、内存 不到 30 GB
10x Visium HD
2 μm 分辨率、按 8 μm 分箱 45.4 万个 spot、1.78 万基因、训练 20 分钟
人肝癌(CosMx)
1000 个基因、120 万个细胞
DSS 结肠炎
140 万
个细胞、52 张切片、训练 近 6 小时
八、对做组学的人,这意味着什么
如果把这篇论文压缩成一句可操作的建议,大概是:空间组学的分析流程,应该把"分割"和"校正"当成两个独立环节来设计。
具体到落地,有三点值得记住:
先分割、再校正,顺序不能反。
resolVI 是后处理,前提是初始分割本身合理。用 ProSeg 起手、Baysor 求精细、resolVI 收尾,是目前比较稳的组合。 判断"降噪是否成功",要同时看两个方向。
该消失的假共表达有没有消失(如 Slc17a6 在微胶质里),该保留的真信号有没有被误伤(如 SPP1 在 TAM 里)。只看前者,很容易把方法用成"过度平滑"。 背景项不是可有可无的装饰。
肝癌里那些"到处都能检出"的低表达标志物,本质是样本级背景,而不是邻居串门。分不清这两者,就会误判细胞类型。
当然,论文本身也把局限写得很清楚:resolVI 依赖 VAE 的潜空间,对潜空间的选择比较敏感,所以提供了监督模式来缓解;而用于评估的"互斥基因对"清单高度依赖具体情境,换一个组织、换一个面板,都需要重新审视。
写在最后
我们常在讨论"测序深度够不够""抗体好不好""质谱分辨率高不高",但对空间组学来说,数据的下限往往由分割和量化这两步决定,而不是由仪器决定。 resolVI 的价值不在于发明了多复杂的模型,而在于它把一件长期被"默认没问题"的事——分子到底属于哪个细胞——摆到了台面上,并给出了一个可计算、可验证、可复现的答案。
它已经开源,集成在 scvi-tools 中(github.com/scverse/scvi-tools)。对正在做空间转录组、单细胞多组学,或者正准备把组织切片数据做深的人来说,这大概是一个值得放进流程里的工具。
方法学上的进步,很多时候不是让我们"看到更多",而是让我们"看错更少"。空间组学走到今天,后者可能更值钱。
参考:Ergen, C. & Yosef, N. ResolVI: addressing noise and bias in spatial transcriptomics. Nature Methods 23, 2003–2014 (2026). doi:10.1038/s41592-026-03212-9